<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="3.9.5">Jekyll</generator><link href="http://ledatablog.com/feed.xml" rel="self" type="application/atom+xml" /><link href="http://ledatablog.com/" rel="alternate" type="text/html" /><updated>2024-06-07T16:15:22+00:00</updated><id>http://ledatablog.com/feed.xml</id><title type="html">Le Data Blog</title><subtitle>Un blog sur la data, l'intelligence artificielle, et mes projets.
</subtitle><entry><title type="html">Introduction au résumé automatique</title><link href="http://ledatablog.com/ia/nlp/python/2021/10/19/introduction-au-resume-automatique.html" rel="alternate" type="text/html" title="Introduction au résumé automatique" /><published>2021-10-19T00:00:00+00:00</published><updated>2021-10-19T00:00:00+00:00</updated><id>http://ledatablog.com/ia/nlp/python/2021/10/19/introduction-au-resume-automatique</id><content type="html" xml:base="http://ledatablog.com/ia/nlp/python/2021/10/19/introduction-au-resume-automatique.html"><![CDATA[<p>Le résumé automatique consiste à prendre un long texte, ou même un ensemble de textes, et à générer
de façon automatique un texte beaucoup plus court qui contient la majorité des informations. Simple ?
Pas tant que ça. D’abord, il faut se mettre d’accord sur quelles informations sont réellement importantes.
Ensuite, il faut pouvoir les extraire correctement, les réorganiser, le tout dans un texte grammatical et 
sans intervention humaine. Et c’est sans compter sur le grand nombre de variantes de types de résumés possibles !</p>

<p>J’ai pu travailler pendant environ un an sur cette thématique passionnante juste avant mon doctorat, ce billet est
donc l’occasion pour moi de me replonger dans ce sujet et de faire le point sur les dernières nouveautés du domaine.</p>

<p>Faisons donc un tour d’horizon de cette thématique, en commançant par décrire les différents types de résumés
qui existent, avant de s’attarder sur deux types de systèmes un peu plus en détails : ceux issus de l’IA et des réseaux 
de neurones, et ceux qui sont plutôt portés sur l’extraction optimale d’informations.</p>

<h2 id="les-différents-types-de-résumé">Les différents types de résumé</h2>

<p>Quand on parle de résumé, on pense souvent à la quatrième de couverture d’un livre ou à la description du 
scénario d’un film. Généralement, ils évitent de spoiler la fin, alors que c’est précisément ce qu’on demanderait
à un outil de résumé automatique classique : raconter l’intrigue, de sorte que le résumé puisse suffire pour connaître
l’essentiel. Ici, il s’agit de <strong>résumés mono-document</strong>, c’est à dire qu’on ne résume qu’un unique document (un film, un livre, un article, …).</p>

<p>On pourrait au contraire vouloir un <strong>résumé multi-documents</strong>, qu’on rencontre plus fréquemment dans le cadre
de revues de presse : on veut disposer d’un condensé des informations les plus importantes telles que rapportées
par divers organismes de presse.</p>

<p>Une fois que l’on a décidé du type de données que l’on cherche à résumer, mono ou multi-documents, on a le choix entre
deux approches : l’<strong>extractive</strong>, qui consiste à extraire telles quelles des informations avant de les recoller pour créer
un résumé, et l’approche <strong>générative</strong>, qui consiste à créer de nouvelles phrases, qui n’apparaissent pas à l’origine dans les
documents, afin d’avoir un résumé plus fluide et plus libre.</p>

<p>En plus de ces critères, il existe divers styles de résumés, que nous n’aborderons pas ici : résumés de mise à jour qui
consistent à résumer les informations apparaissant dans un nouveau document et qui n’étaient pas recensées jusqu’ici, résumés
dirigés qui consistent à adopter un angle précis donné par l’utilisateur, …</p>

<h2 id="lia-et-les-réseaux-de-neurones-révolutionnent-le-résumé-automatique">L’IA et les réseaux de neurones révolutionnent le résumé automatique</h2>

<p>Jusqu’au milieu des années 2010, la plupart des résumés étaient extractifs. Une grande diversité existait pourtant déjà dans
ces algorithmes qui pouvaient aller de la sélection et extraction de phrases entières à l’extraction d’informations précises
recollées ensuite dans des textes à trous préparés à l’avance appelés templates. L’arrivée de nouvelles approches fondées sur
les réseaux de neurones a considérablement changé la donne. Ces algorithmes sont bien plus efficaces que les précédents pour
générer du texte grammatical et fluide, à l’image de ce qu’on peut faire avec <a href="https://transformer.huggingface.co/doc/gpt2-large">cette démo de GPT</a>.</p>

<p>Les réseaux de neurones nécessitent cependant de grandes quantités de données pour être entraînés et sont relativement peu modulables.
Ils fonctionnent parfaitement pour générer des commentaires pour lesquels la véracité a peu d’importance, mais risquent
fortement de générer des informations contradictoires ou simplement incorrectes ce qui est problématique dans le cadre de résumés d’articles de presse par exemple. De nombreux articles de recherche
s’intéressent à ces <a href="https://arxiv.org/pdf/2005.00661.pdf">“hallucinations” des réseaux de neurones</a>.</p>

<h2 id="un-exemple-doutil-hybride--potara">Un exemple d’outil hybride : potara</h2>

<p>Le résumé automatique a été le premier sujet de recherche auquel je me suis intéressé, et j’ai eu l’occasion de développer pendant mon
master un système hybride de résumé par extraction/génération pour une approche multi-documents, c’est à dire résumer un ensemble de documents parlant du même sujet.</p>

<p>L’idée était de partir d’une extraction classique, à savoir repérer les phrases les plus importantes et les assembler pour générer un résumé.
Le problème avec cette approche, c’est que les phrases les plus importantes pourraient souvent être encore améliorées.
Par exemple, dans un article parlant d’un déplacement présidentiel, la phrase “Emmanuel Macron a rencontré son homologue Américain et discuté économie”
pourrait être améliorée en “Emmanuel Macron a rencontré Joe Biden et discuté économie”. Les journalistes évitant soigneusement les répétitions, on se retrouve fréquemment confronté à ce genre de phénomène.</p>

<p>Pour palier ce défaut, on peut repérer des phrases similaires présentes dans différents documents et tenter de les fusionner afin d’obtenir une phrase meilleure. Ansi, à partir des deux phrases suivantes :</p>

<ul>
  <li>Emmanuel Macron a rencontré son homologue Américain à Washington et parlé longuement d’économie.</li>
  <li>Le président Français a rencontré Joe Biden et discuté économie.</li>
</ul>

<p>On peut créer une phrase courte et informative :</p>

<ul>
  <li>Emmanuel Macron a rencontré Joe Biden à Washington et discuté économie.</li>
</ul>

<p>Plusieurs étapes sont nécessaires pour arriver à ce résultat : trouver les phrases similaires, trouver la meilleure fusion, vérifier que la fusion est bien meilleure qu’une phrase originale. Elles tirent partie de nombreuses technologies : réseaux de neurones
type <a href="https://en.wikipedia.org/wiki/Word2vec">Word2Vec</a> pour trouver les phrases similaires,
<a href="https://en.wikipedia.org/wiki/Co-occurrence_network">graphes de co-occurence</a> pour les fusionner,
<a href="https://en.wikipedia.org/wiki/Integer_programming">optimisation ILP</a> pour sélectionner les meilleures fusions.</p>

<p>Si vous voulez en voir davantage, <a href="https://github.com/sildar/potara">potara est open-source</a>, mais n’a pas été maintenu depuis un moment.
Ce projet m’avait notamment servi de vitrine à ma sortie d’étude et avait donc une documentation, des tests, de l’intégration continue, un déploiement sur Pypi, …</p>

<h2 id="quest-ce-quun-bon-résumé-automatique-">Qu’est-ce qu’un bon résumé automatique ?</h2>

<p>Si certains critères semblent évidents et relativement simples à évaluer (la grammaticalité des phrases par exemple), d’autres sont beaucoup plus complexes.
Décider quelles sont les informations les plus importantes d’un texte est déjà une tâche très subjective en soi. En évaluer la fluidité, le bon choix des mots employés, revient à un travail d’édition, et ne parlons pas de l’orientation politique que peut prendre un résumé !</p>

<p>Les nouveaux modèles génératifs à base de réseaux de neurones risquent par exemple d’introduire des jugements ou des qualificatifs péjoratifs
(ou mélioratifs), effet recherché lorsqu’il s’agit de générer une critique de cinéma,
mais beaucoup moins lorsqu’on parle du programme d’un candidat à l’élection présidentielle !</p>

<p>Le résumé automatique reste donc un sujet très actif en recherche, et risque de l’être pour un moment, particulièrement en ce qui
concerne la capacité à orienter le résultat de l’algorithme, justement vers un sentiment en particulier, un style spécifique, une coloration
politique donnée.
Dans l’industrie, il commence juste à faire son entrée dans des cadres bien spécifiques (résumé de réunions par exemple).</p>]]></content><author><name></name></author><category term="IA" /><category term="NLP" /><category term="Python" /><summary type="html"><![CDATA[Tour d'horizon du résumé automatique, une tâche classique du NLP.]]></summary></entry><entry><title type="html">Présidentielles 2022 : À vos data !</title><link href="http://ledatablog.com/data/visualisation/pr%C3%A9sidentielles/2021/09/06/presidentielles-2022-data.html" rel="alternate" type="text/html" title="Présidentielles 2022 : À vos data !" /><published>2021-09-06T00:00:00+00:00</published><updated>2021-09-06T00:00:00+00:00</updated><id>http://ledatablog.com/data/visualisation/pr%C3%A9sidentielles/2021/09/06/presidentielles-2022-data</id><content type="html" xml:base="http://ledatablog.com/data/visualisation/pr%C3%A9sidentielles/2021/09/06/presidentielles-2022-data.html"><![CDATA[<p>J’ai commencé la rédaction de ma thèse à l’été 2016, pour environ un an, à l’époque où la
campagne pour les présidentielles de 2017 battait son plein.
Si l’écriture d’une thèse est un énorme travail, il s’agit davantage d’un marathon que d’un
sprint : il faut écrire chaque jour, se relire régulièrement, se corriger, mais il est presque
impossible d’y être efficace en continu.
C’est également à cette époque que j’ai décidé de ne pas continuer dans la recherche académique.
Il allait donc me falloir trouver un job, et je craignais que l’image du rat de laboratoire,
parfois accolée à tort aux doctorants, ne m’handicape dans ma recherche.
Il me fallait donc trouver un moyen de démontrer ma capacité à travailler sur des projets
concrets, avec des résultats pertinents et compréhensibles.</p>

<p>La campagne présidentielle en cours s’est alors révélée être un parfait side-project pouvant servir à mon
portfolio : je pouvais y accorder du temps de façon discontinue, je serais forcé d’avoir des
résultats rapidement (et avant ma recherche effective d’emploi), et le sujet parlerait à tout le monde.
J’ai donc créé un blog (un autre exercice intéressant en soi), récolté autant de données que je le pouvais,
et commencé à travailler dessus.</p>

<p>À l’heure des présidentielles 2022, je vous propose de faire un tour de 3 sujets data que j’avais mené sur les
à cette occasion, et de vous partager les réussites et les difficultés qui les ont accompagnés.
Si vous êtes un étudiant en fin d’études, ou que vous comptez occuper un poste dans la datascience prochainement,
ce genre de travaux fait clairement la différence parmi les nombreux CV reçus.
D’ailleurs, je suis à peu près sûr que ce sont ces travaux qui m’a permis d’être retenu pour mon premier job : 
datascientist B2B au sein du groupe Ouest-France, chez Additi.</p>

<hr />

<h2 id="projet-n1--suivi-de-la-présence-médiatique-des-candidats">Projet n°1 : Suivi de la présence médiatique des candidats</h2>

<p>Premier projet, qui peut aller du très simple au très complexe : suivre la présence médiatique des candidats.
Le CSA est chargé de s’assurer du respect de l’équité de temps de parole des candidats, et avait à cette occasion publié
en 2017 un suivi des temps de parole pendant la campagne. La page du CSA qui recensait ces informations a 
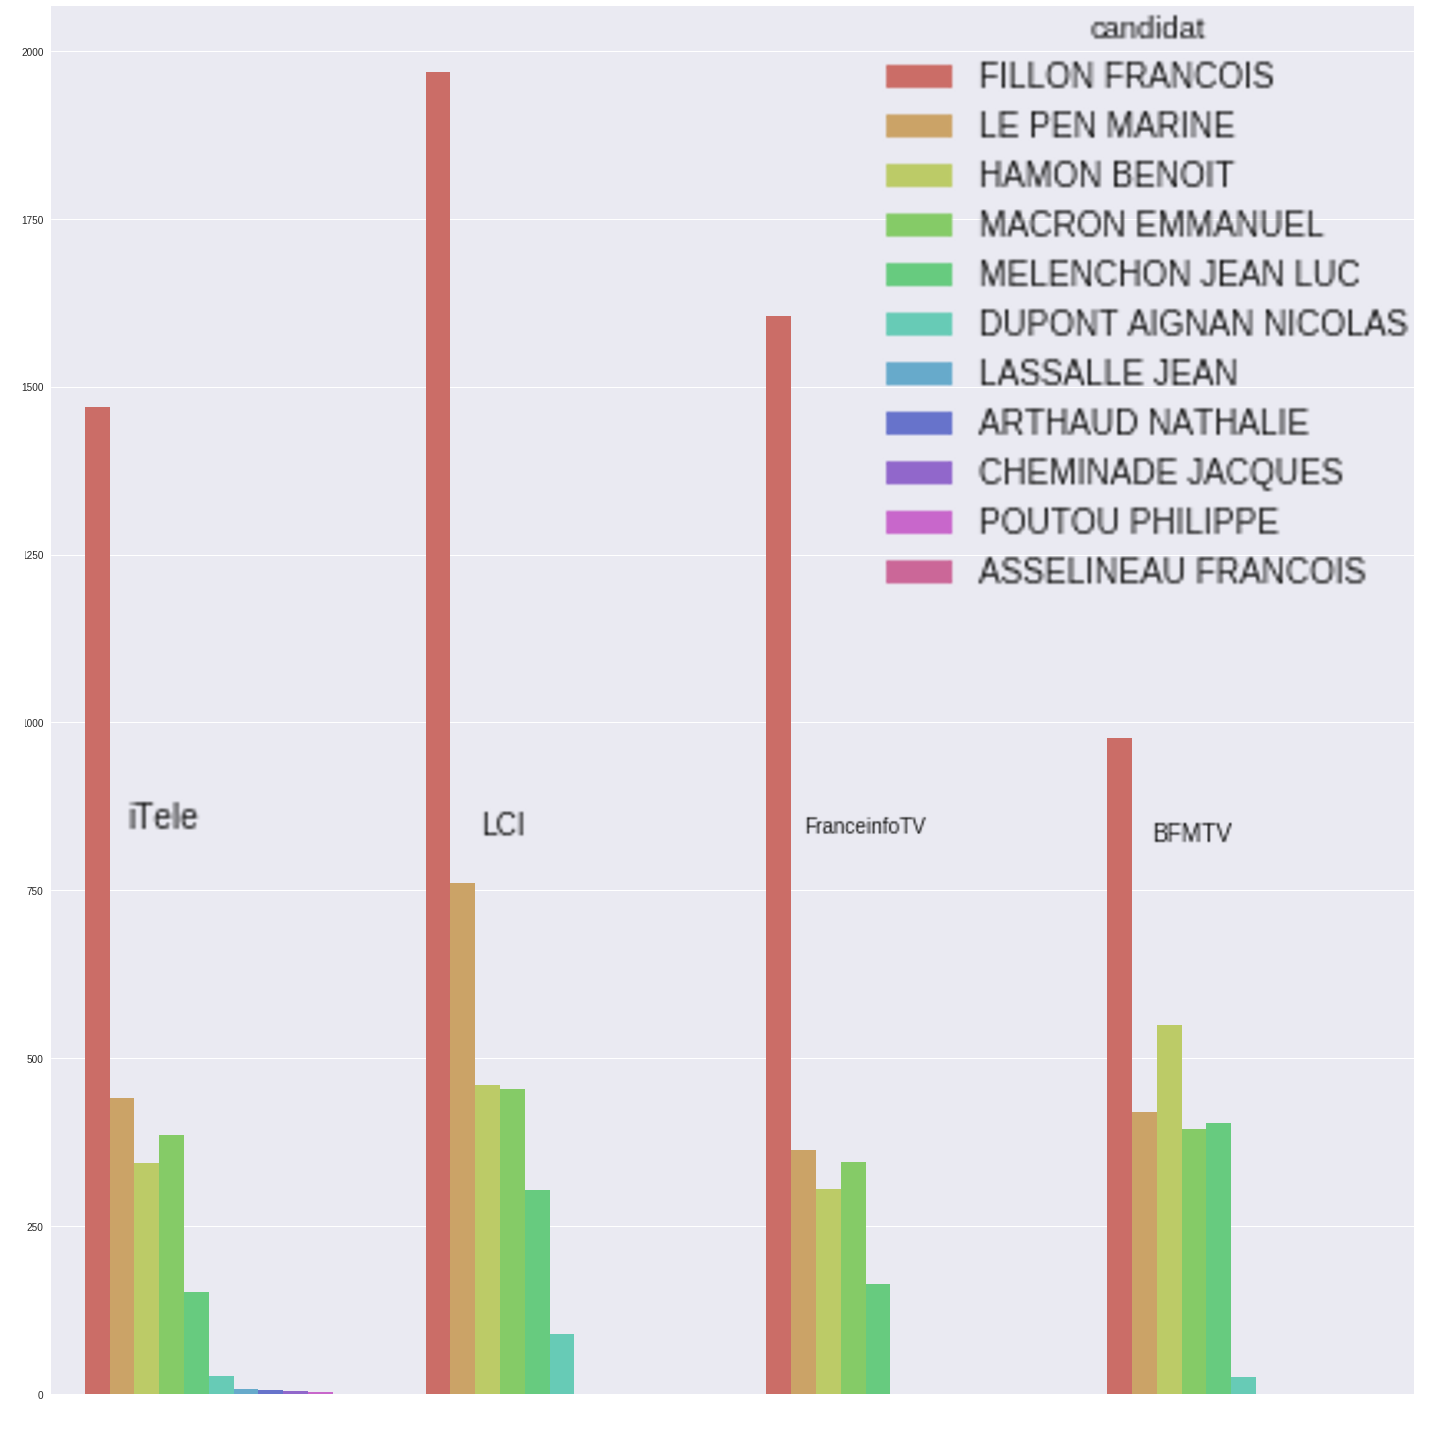
malheureusement été supprimée depuis. On pouvait néanmoins en ressortir ce type de graphe, où l’on pouvait voir la 
surmédiatisation logique de François Fillon lors de “l’Affaire Fillon”, mais aussi à quel point les “petits candidats” 
ont été absents de l’antenne.</p>

<p><img src="/images/content/media-visibility.png" alt="Temps de parole des candidats" style="display: block; margin-left: auto; margin-right: auto; width: 80%" />
<span style="display: block; margin-left: auto; margin-right: auto; text-align:center"><em>Temps de parole des candidats sur 4 chaînes début Janvier 2017</em></span></p>

<p>Il s’agit ici simplement de récupérer les chiffres du CSA et de les mettre en forme. On peut aller du simple
bar chart présenté plus haut à des visualisations dynamiques, voire des <a href="https://www.python-graph-gallery.com/radar-chart/">radar charts</a>. Attention cependant, différentes visualisations peuvent donner des effets très différents, mais
c’est un bon entraînement pour repérer quels graphes sont les plus adaptés à ce genre de données.</p>

<p>On peut aussi vouloir aller plus loin et ne pas se contenter des chiffres fournis par le CSA. On peut pour cela 
s’intéresser à la presse en ligne, qui reste assez accessible. Il suffit alors de créer un programme qui récupère
quelques fois chaque jour les articles des différents sites visés (un crawler), en extrait le contenu principal,
et qui comptabilise le nombre de fois où le nom d’un candidat apparaît. C’est en revanche assez périlleux pour
plusieurs raisons :</p>

<ul>
  <li>chaque site a un format spécifique et il faudra adapter l’extraction du contenu principal</li>
  <li>le crawler peut se faire bannir</li>
  <li>on ne peut pas être exhaustif dans les sources.</li>
</ul>

<p>Candidats.media, dont il ne reste que <a href="https://twitter.com/candidatsmedia">le compte Twitter</a>,
s’était essayé à cet exercice, et y avaient même ajouté une analyse automatique de sentiments afin
de déterminer si les articles étaient positifs ou négatifs pour chaque candidat.
Néanmoins, le choix des sources (parfois pour des raisons techniques plutôt que méthodiques), rend l’analyse
complexe. Par exemple, si vous y incluez Valeurs Actuelles mais pas Médiapart (dont l’aspiration est complexe),
vous aurez probablement une surreprésentation des candidats d’extrême droite.</p>

<p>Une autre solution est de se limiter à une source spécifique (par exemple le <a href="https://www.reddit.com/r/france/">Reddit francophone</a>).
L’analyse n’est alors pas généralisée, mais permet de mettre en lumière de potentiels biais au sein d’une communauté restreinte.</p>

<div style="display: block; margin-left: 20%; margin-right: auto;">
  <ul>
    <li>Les ✔️ :
      <ul>
        <li>Visualisations variées intéressantes</li>
        <li>Présentation Intuitive, compréhensible en un coup d’oeil</li>
      </ul>
    </li>
    <li>Les ❌ :
      <ul>
        <li>Possibilités d’analyses limitées</li>
        <li>Vite biaisé si on sort des chiffres bruts du CSA</li>
      </ul>
    </li>
  </ul>
</div>

<h2 id="projet-n2--analyses-statistiques-des-discours-et-meetings">Projet n°2 : Analyses statistiques des discours et meetings</h2>

<p>Ce qui a été le coeur de mes travaux en 2017 et que j’ai trouvé passionnant : 
l’analyse de discours.</p>

<p>J’ai pensé au début que je pourrais comparer des discours de façon unitaire, et lorsque
Nicolas Sarkozy et Alain Juppé, les deux favoris de la primaire de droite, ont donné leur premier
discours, d’une heure chacun, je me suis attelé à la tâche. Hélas, une heure de discours, c’est
beaucoup, <strong>beaucoup</strong> trop peu pour faire la moindre analyse statistique. Les mots ne se répètaient que
très peu, les thématiques abordées étaient différentes, bref, pas moyen d’en tirer grande chose sauf à faire
un travail qui relève bien plus du journalisme que de l’analyse de données.</p>

<p>J’ai donc sorti la grosse artillerie et recensé le plus de discours possible tout au long de la campagne.
J’ai utilisé des logiciels <em>speech to text</em> (<a href="https://en.wikipedia.org/wiki/List_of_speech_recognition_software">liste ici</a>) pour transformer les flux audio ou vidéo en texte et pouvoir
mener mes analyses de façon automatique.</p>

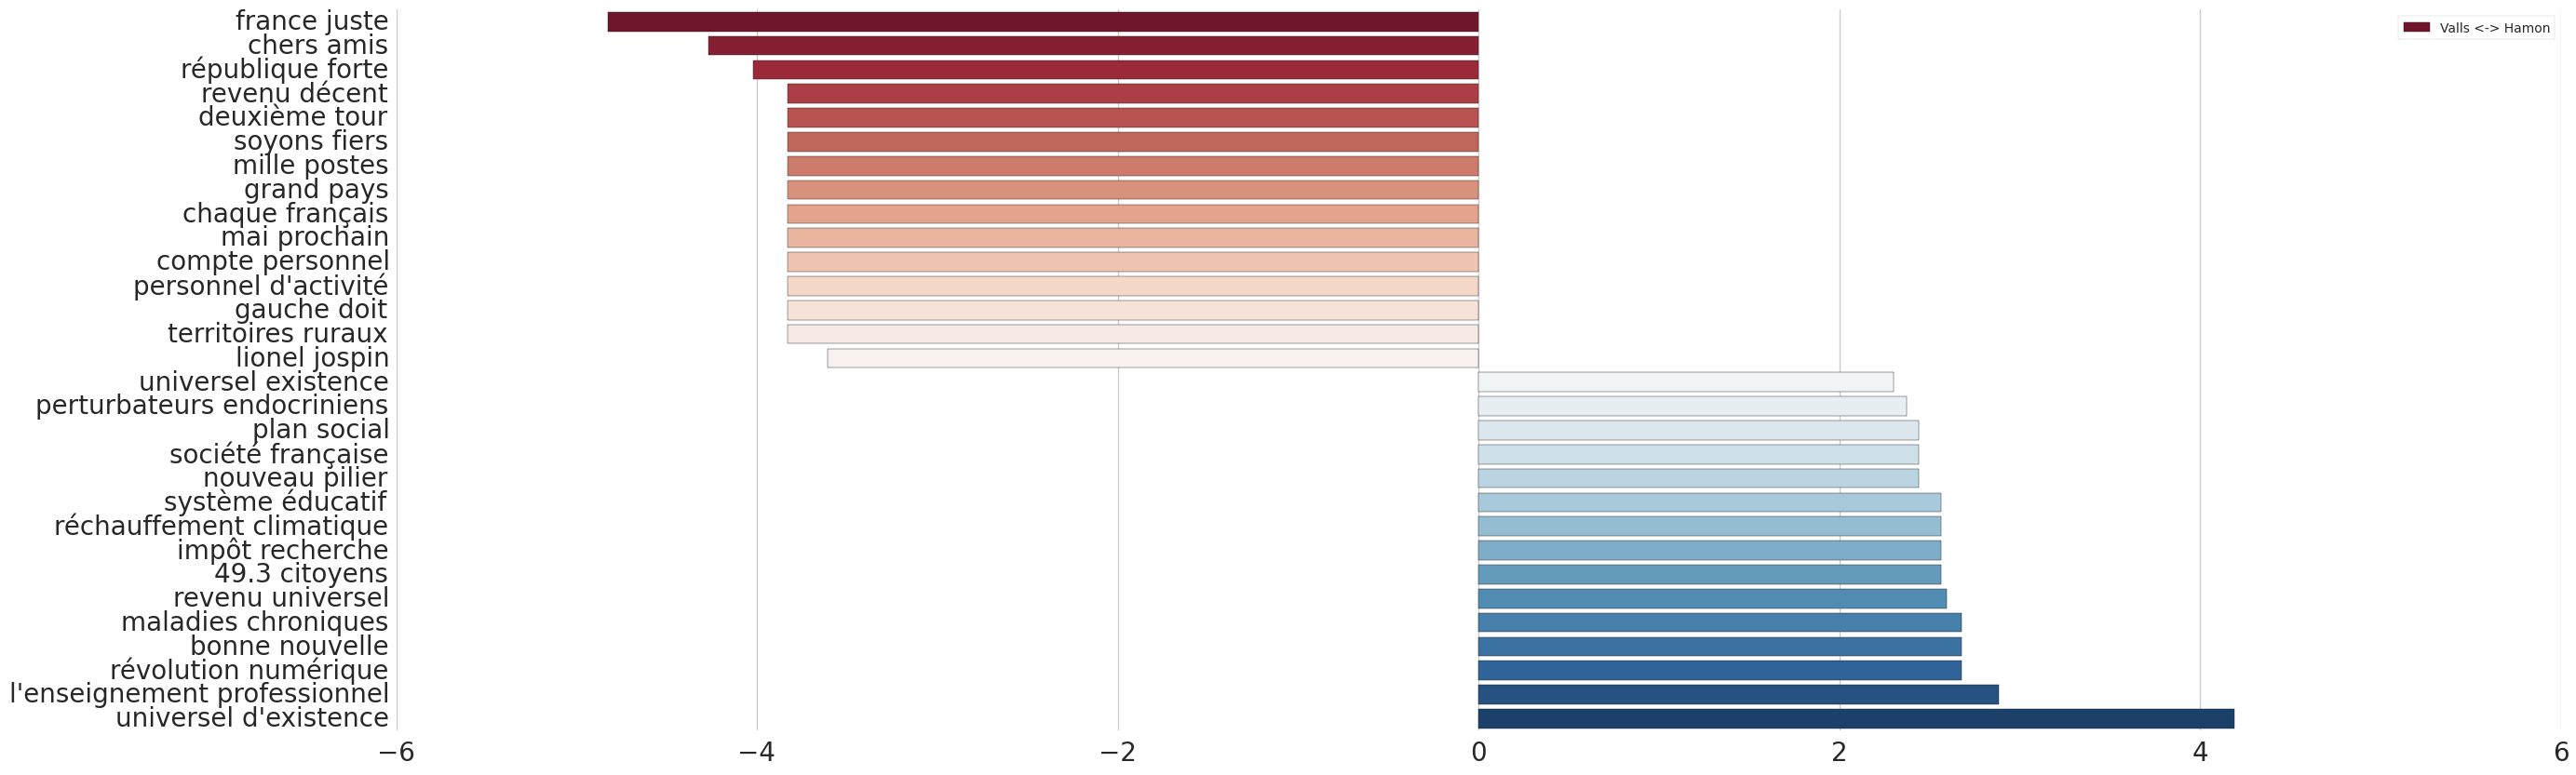
<p>Cela m’a notamment servi au moment de la primaire de gauche. J’ai commencé par faire des nuages finalement assez peu convaincants.
J’ai décidé d’aller plus en profondeur et de comparer les bigrammes (suites de deux mots) qui étaient prononcés
fréquemment par un candidat mais presque jamais par l’autre.
On pouvait alors  voir que les thématiques du programme de Benoît Hamon ressortaient clairement,
tandis que Manuel Valls portait un discours plus générique visant à déjà rallier pour le premier tour
de la présidentielle, à laquelle sa participation lui semblait d’ores et déjà acquise.</p>

<p><img src="/images/content/valls_hamon_discours.png" alt="Termes employés par Manuel Valls et Benoît Hamon pendant la campagne de 2017" style="display: block; margin-left: auto; margin-right: auto; width: 80%" />
<span style="display: block; margin-left: auto; margin-right: auto; text-align:center"><em>Termes employés par Manuel Valls (en rouge à gauche) et Benoît Hamon (en bleu à droite) pendant la campagne de 2017</em></span></p>

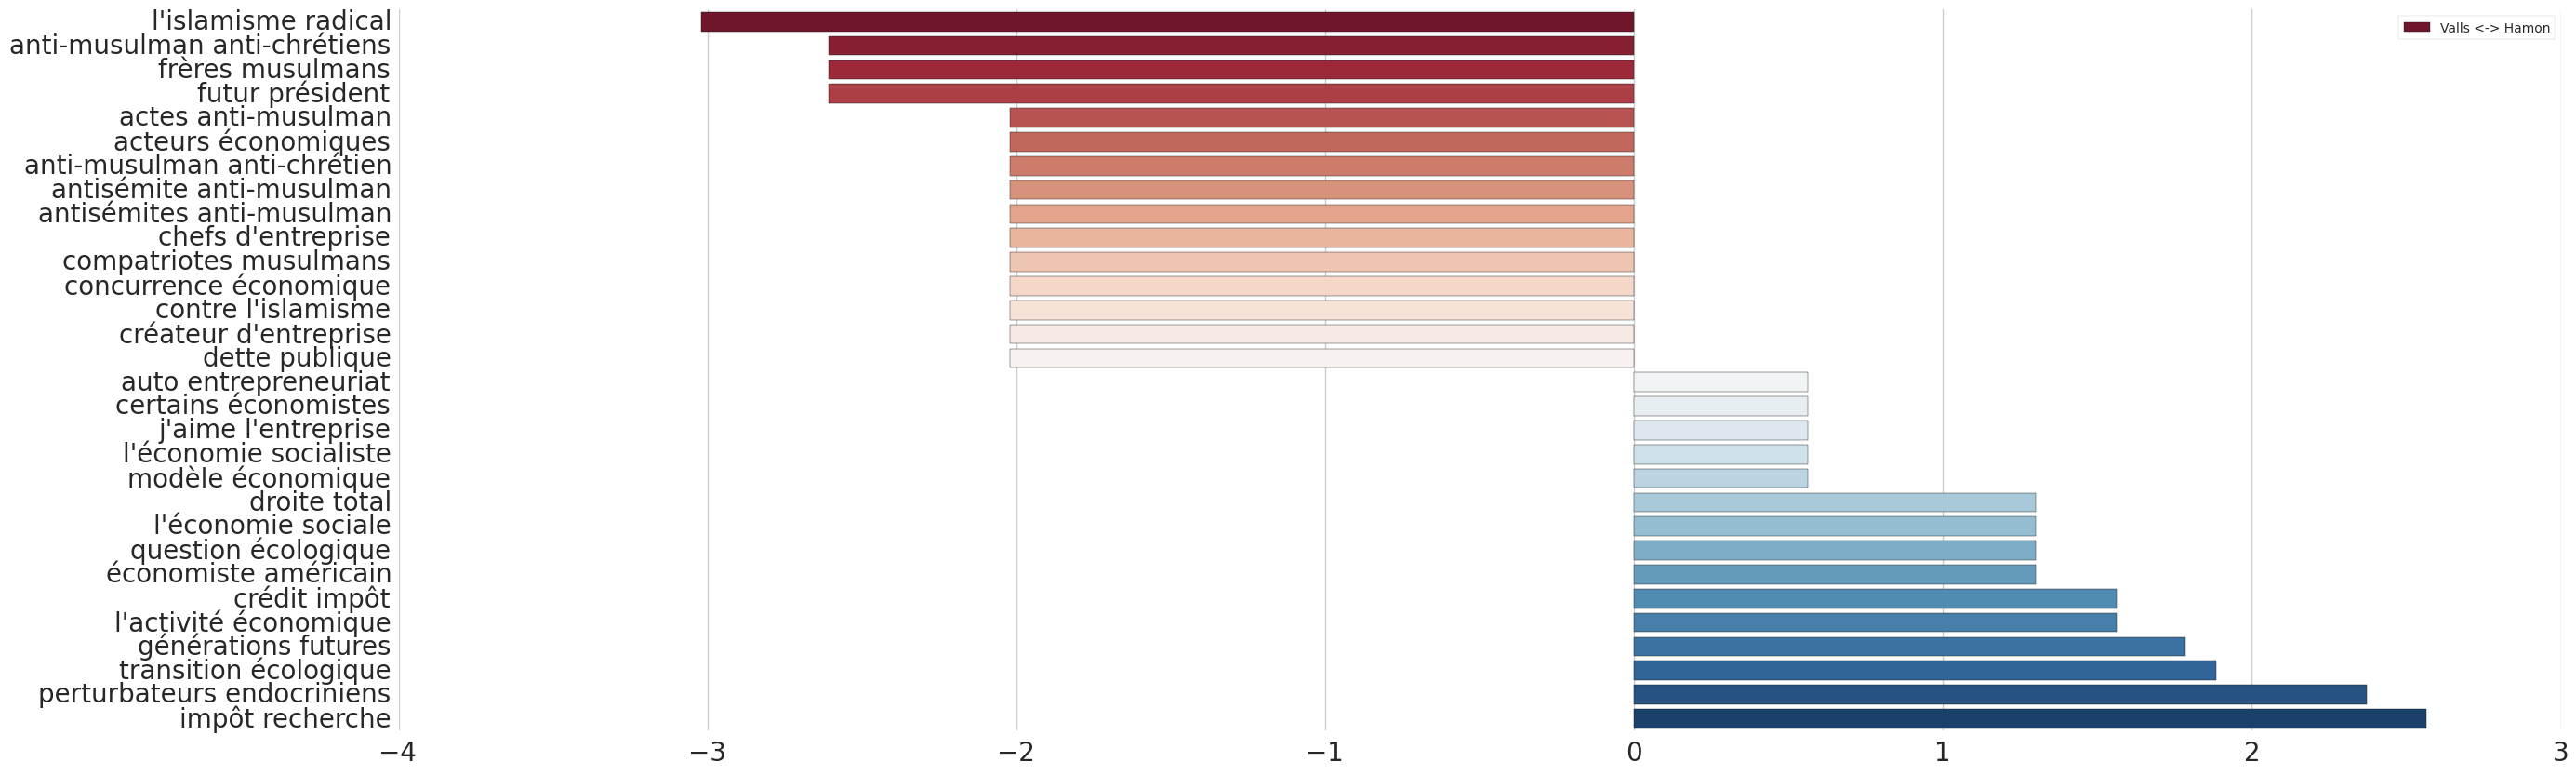
<p>Je me suis également concentré sur quelques thématiques afin de vérifier si elles étaient évoquées de la même façon par les candidats.
Ainsi, lorsqu’on ne regarde que les phrases qui parlent des sujets islam, laïcité, écologie, futur, santé, dette, impôts, entreprises, droite, on peut voir des différences très profondes entre les deux candidats.</p>

<p><img src="/images/content/valls_hamon_thematiques.png" alt="Termes employés par Manuel Valls et Benoît Hamon pendant la campagne de 2017 sur une liste de thématiques" style="display: block; margin-left: auto; margin-right: auto; width: 80%" />
<span style="display: block; margin-left: auto; margin-right: auto; text-align:center"><em>Termes employés par Manuel Valls (en rouge à gauche) et Benoît Hamon (en bleu à droite) centrés sur 8 thématiques</em></span></p>

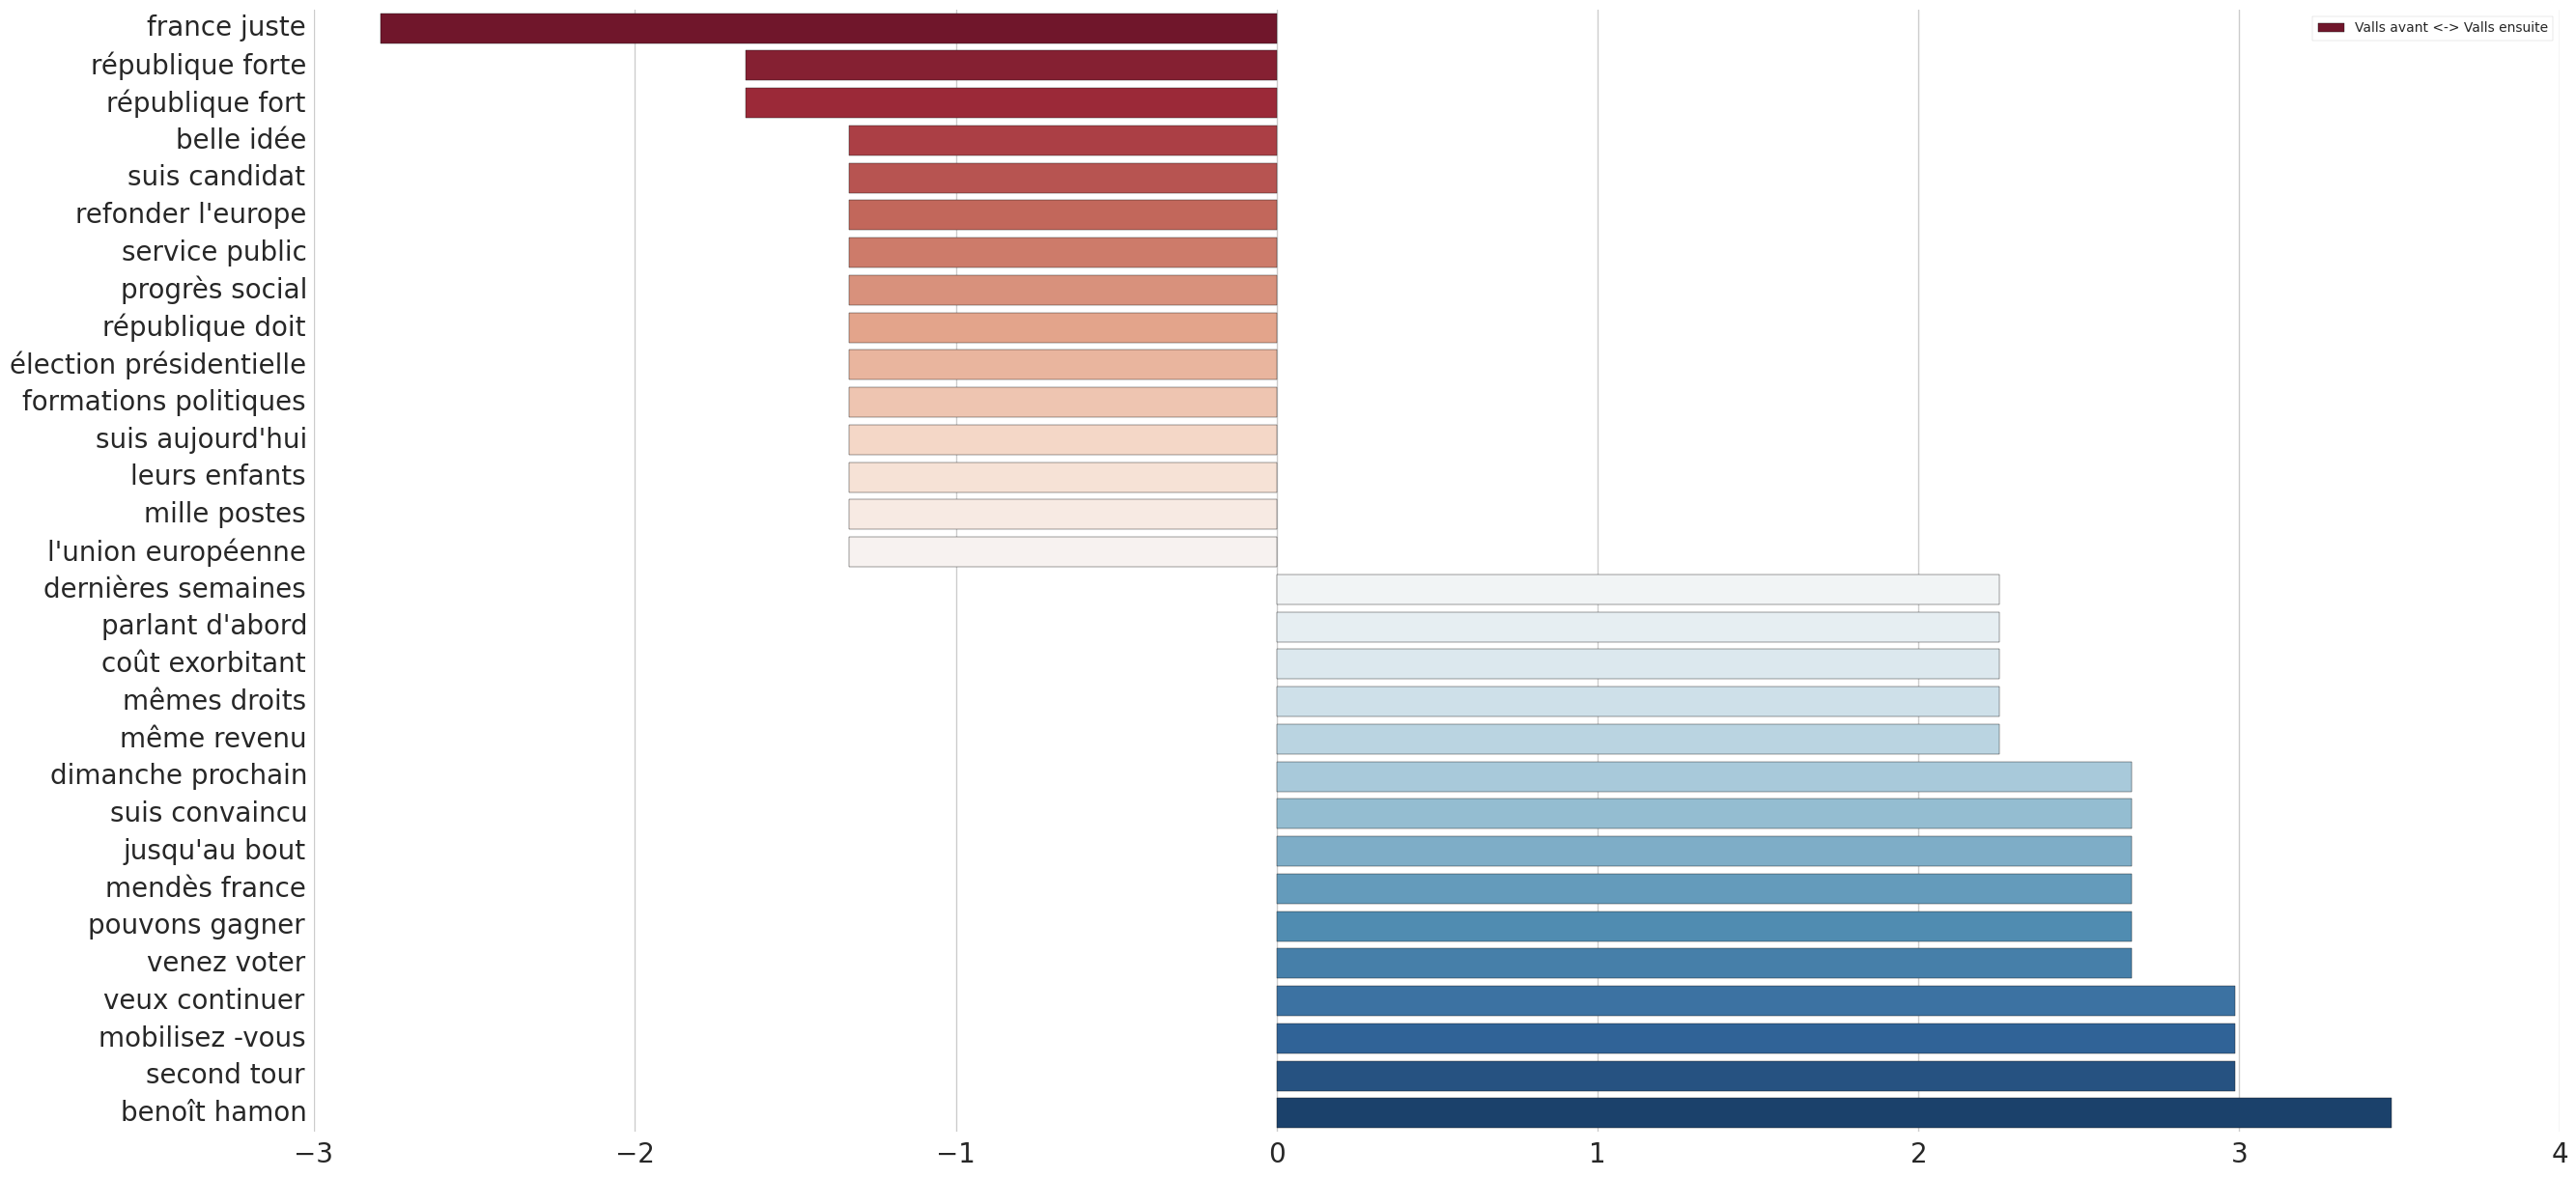
<p>Enfin, il avait été amusant de regarder l’évolution des mots employés par Manuel Valls avant le premier tour des
primaires socialistes et après :</p>

<p><img src="/images/content/valls_avant_apres.png" alt="Termes employés par Manuel Valls avant et après le premier tour des primaires socialistes" style="display: block; margin-left: auto; margin-right: auto; width: 80%" />
<span style="display: block; margin-left: auto; margin-right: auto; text-align:center"><em>Termes employés par Manuel Valls avant le premier tour (en rouge à gauche) et après (en bleu à droite)</em></span></p>

<p>Pour 2022, le Covid rend très peu probable l’organisation de nombreux meetings comme en 2017, et il y a fort
à parier que la communication sera beaucoup plus variée. Il sera donc beaucoup plus difficile d’une part de récupérer
le contenu des discours, et d’autre part de comparer des registres très différents : un candidat qui ne parle
pas de la même façon sur Twitch ou Tik Tok que lors d’un meeting classique. Reste à espérer que les candidats feront
le travail pour nous et recenseront d’eux même l’intégralité de leurs interventions dans un seul endroit pour qu’au 
moins la récupération soit facilitée (certains candidats mettaient ainsi tous leurs discours sur leur compte Youtube
en 2017).</p>

<div style="display: block; margin-left: 20%; margin-right: auto;">
  <ul>
    <li>Les ✔️ :
      <ul>
        <li>Beaucoup de possibilités d’analyses</li>
        <li>Visualisations intéressantes</li>
        <li>Des fun facts pas toujours pertinents mais faciles à partager</li>
      </ul>
    </li>
    <li>Les ❌ :
      <ul>
        <li>Volume finalement pas si élevé</li>
        <li>Nécessité de vérifier minutieusement ses intuitions et analyses</li>
        <li>Beaucoup de tuning et donc un risque de biais dans les analyses</li>
        <li>Difficile d’exploiter autre chose que les discours (interviews, débats, …)</li>
        <li>Données éparpillées, plus encore avec le Covid</li>
      </ul>
    </li>
  </ul>
</div>

<h2 id="projet-n3--suivi-des-comptes-twitter">Projet n°3 : Suivi des comptes Twitter</h2>

<p>Le troisième et dernier axe d’analyse concerne l’exploitation des données Twitter des candidats.
En 2017, il s’agissait du principal réseau social utilisé par les candidats.
C’est moins vrai aujourd’hui avec l’utilisation de plus en plus fréquentes d’autres plateformes
comme Tik Tok, Twitch, Youtube, …</p>

<p>J’avais très tôt aspiré <a href="https://developer.twitter.com/en/docs/twitter-api">grâce à leur API</a> les données des comptes Twitter de nombreux candidats potentiels
(dont la plupart n’y sont pas allés comme Michèle Alliot-Marie, Christiane Taubira ou… François Hollande)
et sauvegardé les informations dans une base SQLite.
Au lendemain de la primaire de droite, alors que François Fillon avait réalisé un score qui avait surpris
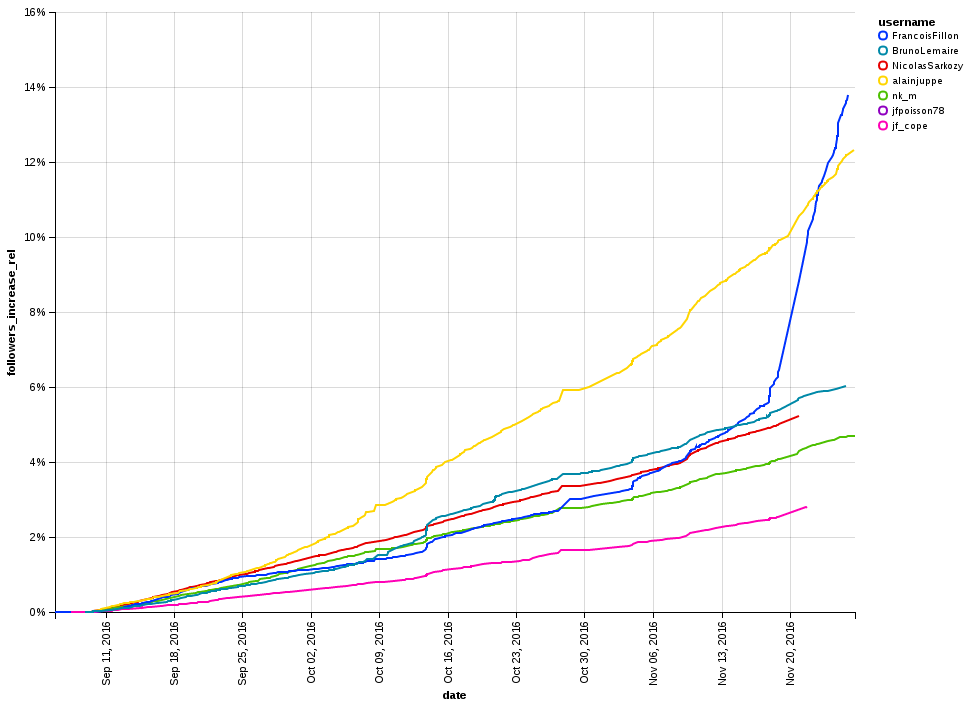
beaucoup de monde, y compris les journalistes, j’avais remarqué qu’une hausse impressionnante du nombre de ses
 followers avait précédé sa victoire de quelques semaines :</p>

<p><img src="/images/content/fillon_dynamique.png" alt="Dynamique de gain de followers sur Twitter avant la primaire des Républicains" style="display: block; margin-left: auto; margin-right: auto; width: 80%" />
<span style="display: block; margin-left: auto; margin-right: auto; text-align:center"><em>Dynamique de gain de followers sur Twitter pour les candidats de droite au moment de la primaire.</em></span></p>

<p>Tandis que tous les candidats étaient sur une dynamique régulière, quelques jours avant le premier tour du 20 novembre, Fillon avait décollé.
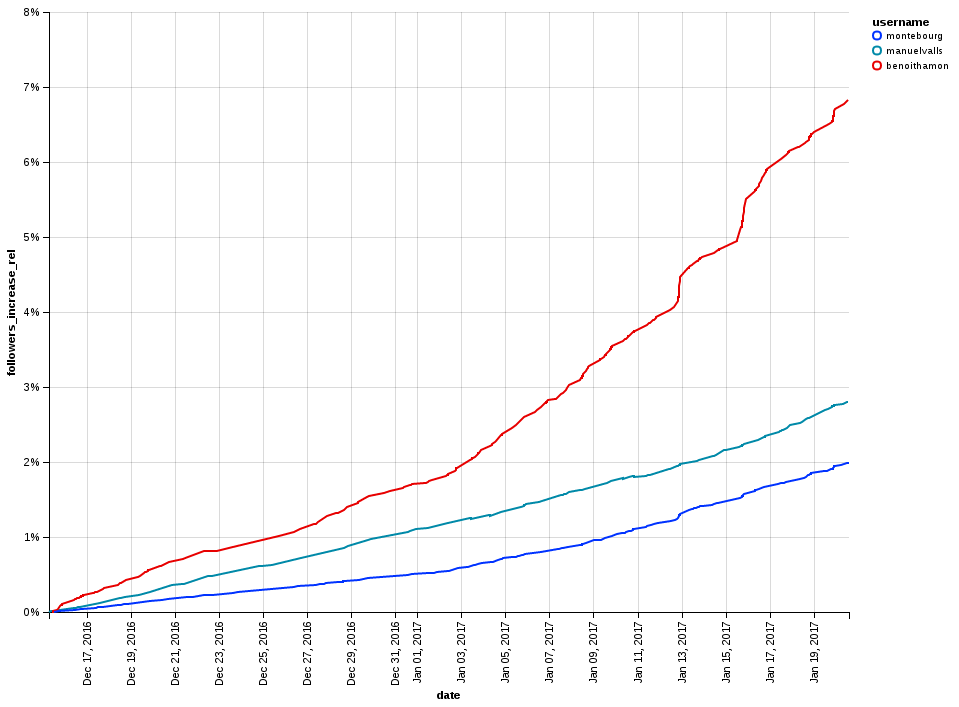
Frustré de ne pas avoir vu cela dans les temps, j’ai répété l’exercice sur la primaire socialiste, et publié ce graphe à la veille du vote :</p>

<p><img src="/images/content/valls_hamon_montebourg_dynamique.png" alt="Dynamique de gain de followers sur Twitter avant la primaire socialiste" style="display: block; margin-left: auto; margin-right: auto; width: 80%" />
<span style="display: block; margin-left: auto; margin-right: auto; text-align:center"><em>Dynamique de gain de followers sur Twitter avant la primaire socialiste pour Benoît Hamon (rouge), Manuel Valls (vert) et Arnaud Montebourg (bleu)</em></span></p>

<p>On peut y voir que Benoît Hamon bénéficiait d’une dynamique de campagne bien plus importante que ses deux rivaux,
alors même qu’il était donné au coude à coude face à Arnaud Montebourg.</p>

<p>Contrairement à ce que ce graphe peut laisser imaginer, il ne prédisait absolument pas la victoire de Benoît Hamon face 
à Manuel Valls. En effet, si on pouvait aisément comparer Hamon et Montebourg qui disposaient d’une base de followers
similaire avant le début de la campagne, il était impossible de les comparer à Manuel Valls qui, en tant que Premier
Ministre, disposait d’un nombre bien plus élevé de followers accumulés au cours de son mandat.
Afin d’obtenir le graphe présenté plus haut, il a donc fallu comparer l’augmentation <strong>relative</strong> du nombre de followers
afin d’éviter ces effets de popularité pré-élections.</p>

<div style="display: block; margin-left: 20%; margin-right: auto;">
  <ul>
    <li>Les ✔️ :
      <ul>
        <li>Travail de récolte intéressant (APIs, filtres, …)</li>
        <li>Des effets parfois pertinents</li>
      </ul>
    </li>
    <li>Les ❌ :
      <ul>
        <li>Difficile de comparer certains candidats entre eux</li>
        <li>Présence de bots risquant de biaiser fortement les résultats</li>
      </ul>
    </li>
  </ul>
</div>

<h2 id="conclusion">Conclusion</h2>

<p>Les présidentielles sont le moment idéal pour mettre à l’épreuve ses compétences en datascience. Elles obligent
à obtenir des résultats dans un temps court et à aller chercher soit même des données souvent éparpillées qu’il
faut stocker, structurer, organiser afin de pouvoir s’en servir de façon fiable plusieurs semaines ou mois plus tard.
Elles obligent à de l’inventivité afin de prodfuire des analyses originales, poussent à mettre en place une plateforme
permettant de partager ses résultats (Medium, Blogger ou site custom comme ce blog),
à réfléchir aux meilleures visualisations possibles, et permettent de progresser
à la fois sur le plan technique, méthodique, et communicationnel.</p>

<p>J’espère que ce retour sur mes expérimentations de 2016-2017 vous auront donné envie de vous investir dans l’analyse
des élections de 2022 !</p>]]></content><author><name></name></author><category term="Data" /><category term="Visualisation" /><category term="Présidentielles" /><summary type="html"><![CDATA[3 exemples de projets data à mener pour les élections présidentielles de 2022.]]></summary></entry><entry><title type="html">Quels livrables pour un projet de datascience ?</title><link href="http://ledatablog.com/data/bi/ia/2020/08/27/quels-livrables-pour-un-projet-data.html" rel="alternate" type="text/html" title="Quels livrables pour un projet de datascience ?" /><published>2020-08-27T00:00:00+00:00</published><updated>2020-08-27T00:00:00+00:00</updated><id>http://ledatablog.com/data/bi/ia/2020/08/27/quels-livrables-pour-un-projet-data</id><content type="html" xml:base="http://ledatablog.com/data/bi/ia/2020/08/27/quels-livrables-pour-un-projet-data.html"><![CDATA[<p>La documentation des projets data, et plus particulièrement de la documentation non technique, n’est que rarement le sujet de billets de blogs qui décrivent plus volontier les projets que les comptes-rendus qui les accompagnent.
Même en Entreprise, la liste des livrables attendus n’est pas toujours explicite, d’autant plus lorsqu’il s’agit de projets internes.
On traite alors entre collègues, et on imagine qu’en cas de besoin on pourra toujours retrouver la datascientist en charge du projet dans le bureau d’à côté.
C’est oublier le <a href="https://swiss-sdi.ch/externaliser-conseils-data-science-eviter-fort-taux-turnover/">fort taux de turnover</a> qui existe dans cette profession très en demande.
On risque alors de se retrouver sans aucune documentation, avec un algorithme en production qui fonctionne mais dont les rouages ne sont connus que d’un unique collègue, voire de plus personne.</p>

<p>Il est alors fréquent de se retrouver après quelques mois avec des algorithmes qui perdent en efficatité, qui ne sont plus mis à jour, ou qui cessent tout bonnement de tourner.
Il faut alors demander au nouveau datascientist de se plonger dans le code, tenter de comprendre le besoin qui existait, comment on y a répondu, et ce qui a changé depuis pour que les performances baissent.
Ce qui aurait dû être un <em>fix</em> de quelques heures de travail ou une mise à jour de quelques jours se transforme alors en une reprise complète de projet qui pourra demander jusqu’à plusieurs semaines de travail.</p>

<p>La solution pour éviter ces écueils est connue de tous mais souvent négligée : la documentation.
Utile non seulement pour reprendre un projet vieux de plusieurs mois ou années, elle est également indispensable au bon déroulement d’un projet.
C’est elle qui permet de fixer par écrit les attendus du client (même lorsque le client est en fait un collègue) ainsi que les risques anticipés.
On s’intéresse dans ce billet à la documentation pour deux types de projets data : ceux qui aboutissent à un algorithme mis en production (algorithmes de recommandation, classification, …) et ceux qui débouchent sur un conseil business (analyse d’usage, pricing, …).</p>

<p>Ce billet vient en complément de l’article “<a href="https://www.ledatablog.com/data/ia/2020/01/16/5-etapes-projet-data.html">Les cinq étapes d’un projet data réussi</a>” et propose une liste de livrables à fournir afin de garder une trace durablement exploitable des travaux réalisés.</p>

<hr />

<h2 id="deux-ingrédients-pour-des-livrables-utiles--la-structure-et-les-illustrations">Deux ingrédients pour des livrables utiles : la structure et les illustrations</h2>

<p>On ne rédige pour ainsi dire jamais une documentation pour soi-même.
Les documents que je décris dans ce billet sont donc avant tout pensés pour être lus par d’autres personnes que leur rédacteur : ses donneurs d’ordres d’une part, et ses futurs remplaçants d’autre part.
Les formats conseillés sont dédiés à un public large, ce qui les rend pratiques pour se remémorer un projet réalisé plusieurs années auparavant, de façon bien plus efficace qu’une plongée dans un vieux code source.</p>

<p>À cette fin, l’ensemble des livrables doivent obéir à deux règles : clarté et compréhensibilité.
La première s’obtient grâce à une structure claire et aérée : des sections bien titrées, une table des matières, une charte graphique cohérente et régulière, des légendes, …
La seconde s’obtient par des paragraphes bien construits, des idées claires et clairement exprimées, des enchaînements logiques et des visualisations efficaces.</p>

<p>Attention cependant à ne pas inclure trop d’illustrations. Parfois, une ou deux phrases sont plus claires qu’un tableau ou qu’un graphique.
D’autre part, les rapports trop longs ne sont pas lus, il faut donc arbitrer et n’inclure que les éléments importants.
Cet équilibre ne s’obtient qu’à force d’entraînement, et lorsqu’on a de la chance, par les retours que l’on veut bien nous donner.</p>

<hr />

<h2 id="rapport-danalyse-des-besoins">Rapport d’analyse des besoins</h2>

<p>Le principal risque d’échec des projets data, comme pour la plupart des projets informatiques, se situe dans une mauvaise compréhension du besoin client.
Le risque est encore plus grand lors d’une reprise de projet, pour laquelle le client souhaite une amélioration des performances ou une mise à jour des données du modèle.
La datascientist, si elle n’a pas de documentation à disposition, risque alors de ne pas avoir une vision claire des exigences et des attendus du client, et d’apporter des améliorations qui s’avèreront au final contre-productives (par exemple intégrer un segment de clientèle non pertinent, déséquilibrer le compromis rappel/précision, …).</p>

<p>C’est pourquoi le premier livrable à fournir, indispensable à la bonne conduite de tout projet data, est un rapport des besoins exprimés et des solutions envisagées.
Ce rapport, rédigé généralement sur Word ou autre traitement de texte (et pas Powerpoint!), fait généralement quelques pages et décrit les éléments suivants :</p>

<ol>
  <li>Problématique générale : état actuel, personnes ou services concernés, besoins exprimés, …</li>
  <li>Objectifs chiffrés visés : performance minimale permettant l’amélioration de la situation courante</li>
  <li>Exigences non négociables : temps de calcul, précision, réactivité, …</li>
  <li>Périmètre des données utilisées : périodes, volume, champs et types, sensibilité durée de conservation, …</li>
  <li>Solution générale envisagée : méthodologie</li>
  <li>Risques, limites et impacts attendus : prérequis, durabilité, fiabilité, saisonnalité, …</li>
  <li>Récurrence envisagée : fréquence et automatisation des mises à jour, validité de l’étude dans le temps, …</li>
</ol>

<p>Ces 7 points permettent de valider avec le donneur d’ordres (ou <em>stakeholder</em>) le réalisme de la solution et surtout sa viabilité pour une utilisation en production ou pour une prise de décision.
Ce dialogue avec le <em>stakeholder</em> est central dans tout projet de datascience, et je vous conseille <a href="https://towardsdatascience.com/how-to-work-with-stakeholders-as-a-data-scientist-13a1769c8152">la lecture de cet article</a> (en anglais) si vous souhaitez creuser le sujet.
Ces 7 points permettent également d’estimer le temps nécessaire au projet, les risques qu’il comporte, les besoins de mise à jour anticipés, et permettent éventuellement d’établir les prochains points d’étape.
Ils sont indispensables au chiffrage du projet et forment la base de travail, le <em>contrat</em> que vous passez avec le porteur de projet.</p>

<p>Ce livrable porte essentiellement sur les besoins et les aspects techniques doivent y être très légers.
D’abord parce qu’ils n’intéresseront probablement pas le destinataire de ce rapport, ensuite parce qu’ils pourront évoluer au fur et à mesure que le projet avance.</p>

<p>De manière générale, on pourra se passer de mentionner l’algorithme précis, le langage de programmation, les librairies utilisés.
Il s’agit à ce stade d’une part de rassurer le donneur d’ordres sur la capacité à faire, et d’autre part de mieux estimer le temps de développement nécessaire, la construction d’un réseau de neurones complexe ne nécessitant pas le même travail qu’un K-NN (ni le même volume de données, ni les mêmes ressources).
Par exemple, pour un besoin de type segmentation de clientèle, dire que des méthodes de <em>clustering</em> sont envisagées suffira amplement.</p>

<p>L’analyse de besoins n’est pas toujours lue avec attention pas le porteur de projet.
Il revient au datascientist de le rendre le plus lisible et le moins technocentré possible pour faciliter sa lecture.
Un soin particulier doit être apporté aux trois premiers items qui sont ceux qui intéressent le plus le donneur d’ordre, les items suivants servant essentiellement à se prémunir contre des imprévus et à préciser les besoins de l’analyste (volume de données par exemple).</p>

<hr />

<h2 id="livrables-intermédiaires">Livrables intermédiaires</h2>

<p>Les livrables intéremédiaires sont les moins critiques dans le sens où certains d’entre eux risquent d’être rendus invalides au cours du projet (jeu de données vicié, bugs non détectés, …).
Il y en a néanmoins un qui a une utilité indéniable : l’étude du corpus.</p>

<h3 id="etude-des-données">Etude des données</h3>

<p>Ce document est essentiellement à l’usage des datascientists pour leur permettre de recenser tous les biais et autres limites d’un jeu de données.
Anomalies, absences, complétude, saisonnalité, suspicions d’erreurs, fraîcheur, le moindre doute doit y être consigné, que l’on puisse le confirmer ou non.
Cet inventaire peut être en partie partagé avec le donneur d’ordres afin d’envisager des améliorations en termes de récolte ou de maintenance des données.
Il permet également d’affiner l’évaluation des risques et l’estimation de la durée du projet (une phase de nettoyage ou de redéfinition du périmètre devant généralement intervenir à cette étape).</p>

<p>Une fois l’étude de corpus réalisée, le projet peut réellement débuter, et les analyses statistiques ou le développement d’algorithmes démarré.
Intervient alors une phase plus où moins longue de travail, qui va donner lieu à des résultats intermédiaires.</p>

<h3 id="résultats-intermédiaires-et-baseline">Résultats intermédiaires et baseline</h3>

<p>Si le projet dure longtemps, il est important de faire des points d’avancement réguliers.
Ceux-ci serviront d’une part à rassurer le porteur de projets que le sujet avance, mais peut également permettre de remettre en question certains besoins, de poser des questions sur certaines données semblant abbérantes, … autant d’éléments qu’il vaut mieux prendre en considération le plus tôt possible.</p>

<p>Néanmoins, ces résultats intermédiaires ne sont pas toujours entièrement fiables : le périmètre de données continue d’évoluer au fur et à mesure que de nouvelles anomalies sont détectées, les tests s’assurant de la correction du code n’ont pas tous été écrits, les attentes peuvent évoluer à la marge.
Pour cette raison, les échanges avec les <em>stakeholders</em> se font essentiellement à l’oral, avec un support Powerpoint qui n’est pas nécessairement partagé, ou alors avec une notice d’avertissement sur la fiabilité des résultats.</p>

<p>La seule exception concerne le développement éventuel d’une <em>baseline</em>, qui doit être correctement testée et qui doit fixer définitivement le jeu de données utilisé.
Si <em>baseline</em> il y a, un rapport fonctionnel présentant la méthode utilisée et les résultats obtenus doit être rédigé.
On y retrouvera les informations suivantes :</p>

<ul>
  <li>Rappel du sujet et référence à l’étude de besoins et à l’étude de corpus</li>
  <li>Description du jeu de données utilisé, des traitements réalisés, des limites et des principaux biais</li>
  <li>Présentation de la méthode sélectionnée pour la baseline</li>
  <li>Liste des principaux paramètres de la baseline</li>
  <li>Affichage des résultats et performances</li>
  <li>Rédaction du différentiel de performance attendu par rapport à la méthode complète</li>
</ul>

<p>À mon sens, il n’y a pas besoin à ce stade de Powerpoint, sauf à l’utiliser comme un support de communication orale au même titre que les autres résultats intermédiaires (1 ou 2 slides sur la baseline seront de toute manière repris dans le rapport final).
Il doit néanmoins être rédigé de façon détaillée afin de permettre de bien comprendre les résultats obtenus et le périmètre sur lequel ils s’appliquent.
Il peut arriver qu’à la lecture de ce rapport, le projet soit arrêté.
Soit la <em>baseline</em> fait le job, soit on est trop loin et on estime les chances de succès trop faibles pour poursuivre.
Un rapport de post-mortem doit alors être rédigé, sur le modèle des livrables de fin de projet décrits après.</p>

<hr />

<h2 id="livrables-de-fin-de-projet">Livrables de fin de projet</h2>

<p>Arrive la fin du projet. Les résultats sont là, ils sont vérifiés, l’algorithme fonctionne et a été testé. Il ne reste plus qu’à fournir la documentation.
À cette étape, il me semble indispensable de fournir deux supports : un rapport fonctionnel, rédigé et donnant les détails permettant de comprendre comment les analyses ont été menées, et un <em>executive summary</em>, c’est à dire un Powerpoint d’une dizaine de slides qui récapitule le projet et les résultats obtenus.
Ce dernier support sera souvent le seul lu et conservé précieusement par le <em>stakeholder</em>.
Si vous avez suffisamment bien fait votre travail, il y a de grandes chances qu’il en extraie même quelques slides pour en rapporter à sa direction.
Il est donc dans votre intérêt de rendre le document le plus propre et exploitable possible.</p>

<h3 id="executive-summary-et-rapport-fonctionnel">Executive summary et rapport fonctionnel</h3>

<p>L’<em>executive summary</em> doit reprendre les élements suivants :</p>

<ul>
  <li>Expression du besoin : Besoin, contraintes, amélioration par rapport à l’existant</li>
  <li>Choix méthodologiques : Philosophie, quelles contraintes ont mené à la solution choisie</li>
  <li>Présentation de la solution : Intuition derrière la méthode (<em>look-alike</em>, <em>réseau de neurones</em>, <em>scoring</em>, …)</li>
  <li>Résultats : Chiffres bruts obtenus par la méthode</li>
  <li>Limites : Cas d’erreur, validité temporelle, biais, …</li>
  <li>Impact et suites à donner : Evolution attendue des KPI, actions à mettre en place, …</li>
</ul>

<p>Chaque élément ne devrait pas faire plus de 2 slides et chaque slide ne devrait comporter que quelques lignes de texte.
En particulier, les points techniques n’ont pas à y figurer, et l’explication de la solution doit être simple, intuitive et courte.
La lecture de ce document doit permettre de comprendre ce qui a été fait, pourquoi, et avec quels impacts attendus.</p>

<p>Il s’accompagne d’un rapport fonctionnel détaillé, qui reprend ces différents points en les précisant, et en décrivant succintement les choix technologiques.</p>

<h3 id="algorithmes">Algorithmes</h3>

<p>Si l’un des attendus est un algorithme, celui-ci doit logiquement être livré proprement (code commenté, dépendances, entrées et sorties, …) et débarrassé de tout le code mort, y compris celui ayant servi aux diverses expériences n’ayant pas abouti.
Il est également essentiel de décrire les outils ou bibliothèques dont il dépend, les versions utilisées, bref, tout ce qui permettra de reproduire vos résultats sans avoir à se poser de questions.
De nombreuses ressources s’intéressent à comment documenter correctement du code, à comment le versionner et le distribuer efficacement (<a href="https://towardsdatascience.com/clean-code-for-a-data-scientist-f4b760374b74">en voici un exemple arbitraire</a>).</p>

<hr />

<h2 id="les-autres-types-de-rapports">Les autres types de rapports</h2>

<p>À mon sens, la liste des livrables indispensables s’arrête ici. J’ai néanmoins l’habitude d’en préparer d’autres, que je ne distribue pas systématiquement :</p>

<ul>
  <li>Un état de l’art explicitant les alternatives possibles en termes d’algorithmes ou d’architectures</li>
  <li>Une analyse précise des cas d’erreurs avec leur recensement, des explications, des suppositions (Word + Excel pour des données structurées)</li>
  <li>Un mémo des améliorations possibles (un simple fichier .txt y suffit)</li>
  <li>Une version courte et interactive de l’algorithme via <a href="https://jupyter.org/index.html">un notebook</a>.</li>
</ul>

<p>Tous ces supports ne se justifient pas pour tous les projets (par exemple l’état de l’art n’a pas grand intérêt pour une analyse statistique classique), néanmoins ils peuvent s’avérer pratiques par la suite.
Je pense notamment à la version courte de l’algorithme, qui permet d’avoir une version nettoyée de tout l’historique du projet et allant à l’essentiel, utile lorsqu’il n’y a pas de code livré mais que l’on souhaite garder une trace.
Cela permet également une vérification supplémentaire de la fiabilité des résultats en réécrivant <em>from scratch</em> l’algorithme afin de vérifier l’absence de bug ou d’effet de bord.</p>

<p>L’analyse des cas d’erreurs peut s’avérer précieuse, elle devrait être réalisée, a minima partiellement, avant la fin du projet afin d’assurer sa robustesse.
Néanmoins, il faut prendre garde à ne pas conserver de données qui pourraient tomber sous le coup de la RGPD (et donc veiller a minima au cycle de vie des données personnelles).</p>

<p>Le mémo des améliorations possibles est le seul document que je conseille de rédiger au format .txt.
Ce document est pour vous, et pour vous seul.
Il n’a pas à être compris par quelqu’un d’autre, il peut être truffé d’abbréviations, d’approximations, d’idées farfelues, sans structures et rempli de fautes : lâchez-vous !</p>

<hr />

<h2 id="les-risques-inhérents-aux-livrables">Les risques inhérents aux livrables</h2>

<p>Tout ce qui a été dit ici peut paraître évident : documenter et avoir des livrables clairs semble être bénéfique a tout le monde.
Pourquoi alors est-il fréquent de se retrouver avec des projets sans aucune documentation ?</p>

<p>Trois facteurs majeurs entrent pour moi en compte.</p>

<p>D’abord, et c’est certainement le point le plus critique, rédiger ces documents engage le datascientist.
Cela l’amène à écrire noir sur blanc ses suppositions, et peut mettre en lumière des risques mal anticipés, des prédictions trop optimistes, des intuitions erronnées.
Écrire ces rapports, c’est accepter d’assumer ses erreurs, y compris face à des clients qui peuvent prendre ces erreurs pour de l’incompétence.
Dans un domaine ou le <a href="https://caitlinhudon.com/2018/01/19/imposter-syndrome-in-data-science/">syndrôme de l’imposteur est extrêmement présent</a>, la réticence à documenter précisément ses travaux pour se protéger est donc un mécanisme de défense naturel.</p>

<p>Ensuite, la plupart des livrables à fournir nécessitent une simplification des approches utilisées, et omettent généralement une grande partie des expérimentations réalisées.
Ceci peut aboutir à un sentiment de simplicité du travail réalisé, pour lequel on peut finir par se demander si tant de temps était nécessaire et si des compétences spécifiques étaient réellement indispensables.
Le risque, bien plus critique que le fait de renvoyer une image peu flatteuse au datascientist, est que des travaux similaires soient plus tard confiés à des personnes moins compétentes, qui travailleront sans se rendre compte de la myriade de pièges dans lesquels elles tombent.</p>

<p>Enfin, la description précise des méthodes employées a pour but d’éviter la concentration des connaissances sur une ou quelques personnes.
En conséquence, cette mise à disposition des connaissances rend la datascientist moins indispensable.
Fréquemment, lorsqu’une question se pose sur le fonctionnement de l’algorithme, un simple coup d’oeil à une documentation bien construite permet de trouver la réponse.
L’absence de documentation, au contraire, risque de mener le datascientist a être systématiquement dérangé pour répondre à des questions, souvent les mêmes.
Ces deux postures ont des avantages et des inconvénients : temps libéré d’un côté au prix d’une dépossession, contrôle renforcé de l’autre en contrepartie d’un service après-vente alourdi.</p>

<p>Mon choix personnel est de parier sur une documentation large et exhaustive.
D’abord parce que cela me permet régulièrement de corriger des présupposés (sur les besoins, les données, …) qui auraient pu mettre en difficulté le projet.
Ensuite parce qu’il aide grandement à tisser une relation de confiance avec ses interlocuteurs.
La crédibilité des résultats s’en trouve renforcée et on augmente la probabilité que les travaux réalisés soient effectivement utilisés.
Enfin parce que j’estime que ma valeur ne réside pas tant dans le fait d’être capable d’implémenter et de paramétrer des algorithmes complexes, mais dans ma capacité à choisir la meilleure solution pour un problème donné en fonction des besoins et des contraintes.
Les rapports rédigés sont la meilleure démonstration possible de ces compétences, et tout le monde y gagne.</p>

<hr />]]></content><author><name></name></author><category term="Data" /><category term="BI" /><category term="IA" /><summary type="html"><![CDATA[On parle rarement des documents à rédiger et à livrer dans le cadre des projets data. Or, ils sont indispensables à tout projet bien mené.]]></summary></entry><entry><title type="html">Visualisation : faire passer un message avec la data</title><link href="http://ledatablog.com/data/visualisation/covid/2020/05/13/faire-passer-un-message-avec-la-data.html" rel="alternate" type="text/html" title="Visualisation : faire passer un message avec la data" /><published>2020-05-13T00:00:00+00:00</published><updated>2020-05-13T00:00:00+00:00</updated><id>http://ledatablog.com/data/visualisation/covid/2020/05/13/faire-passer-un-message-avec-la-data</id><content type="html" xml:base="http://ledatablog.com/data/visualisation/covid/2020/05/13/faire-passer-un-message-avec-la-data.html"><![CDATA[<p>Avoir des données c’est bien. Les enrichir, les étendre, s’en servir pour faire de la prédiction, c’est mieux. Mais ce n’est souvent pas suffisant.
Pour que la donnée serve vraiment, il faut qu’elle nous apprenne, à nous humains, à mieux comprendre les phénomènes qui nous entourent.
La visualisation joue un rôle crucial à cet étape, et il existe des dizaines de façons de représenter la donnée, des “camemberts” aux <a href="https://upload.wikimedia.org/wikipedia/commons/thumb/e/ec/Energy_US_2015.png/1920px-Energy_US_2015.png">diagrammes de Sankey</a>.
Le but d’une visualisation est le plus souvent de faire passer un message, et de multiples paramètres existent pour donner forme à ce message : choix de la représentation, couleurs, seuils, …</p>

<p>Je vous propose aujourd’hui de nous attarder sur un format particulier : les choroplèthes. Derrière ce nom un peu barbare ce cache un type de visualisation familier de tous : les cartes colorées.
Dans le contexte actuel de covid, nous allons regarder une <a href="https://insee.fr/fr/statistiques/4488433#consulter">carte fournie par l’INSEE le 12 Mai 2020</a>, qui montre la surmortalité dans chaque département français en mars et avril 2020.
On va d’abord lire “naïvement” cette carte, chercher à en tirer les principaux enseignements sans regarder les données exactes qui ont servi à la générer (et que l’INSEE rend disponible par ailleurs).
Nous iront ensuite regarder de plus près les données afin de vérifier que les intuitions que la carte nous a donné sont exactes.
Enfin, nous verrons comment, à partir des mêmes données, nous pouvons générer une carte différente, qui fait passer un message complètement différent, sans pour autant être déloyal.</p>

<h1 id="la-carte-de-la-surmortalité-covid-19-en-france">La carte de la surmortalité covid-19 en France</h1>

<p>Sans plus attendre, jetons un oeil à la carte de l’INSEE. On va ensuite séparer sa lecture en deux phases : une lecture générale (légende, couleurs, …) et une lecture de compréhension (ce que la carte nous apprend).</p>

<p><img src="/images/content/surmortalite_insee.png" alt="Carte INSEE sur la surmortalité covid-19 en Mars-Avril 2019" style="display: block; margin-left: auto; margin-right: auto; width: 60%" /></p>

<h2 id="informations-générales">Informations générales</h2>

<p>Il s’agit donc d’un choroplèthe avec 4 couleurs, allant du bleu clair au rouge, une échelle “froid-chaud” dont on peut deviner sans avoir à lire la légende que les zones “froides” (bleues) sont celles avec une mortalité faible, et que plus on tire vers le rouge, plus la mortalité est élevée.
Les couleurs sont appliquées sur les départements, les outre-mer sont bien présents, et on a, comme souvent, un zoom sur le centre de l’Île de France pour pouvoir constater les différences entre les trois départements entourant Paris : le Val de Marne, la Seine Saint Denis, et les Hauts de Seine.</p>

<p>L’échelle semble logique, avec la couleur bleue appliquée aux départements ayant une surmortalité négative (“moins de 1.0”), c’est à dire qu’il y a moins de décès que d’habitude, du orange clair vers le rouge pour les départements où la surmortalité est positive.
Le rouge est réservé aux départements où le nombre de décès est à 200% ou plus, c’est à dire que la mortalité y a plus que doublé.</p>

<p>La période considérée va du 2 mars au 19 avril 2020, et la surmortalité est logiquement comparée à la moyenne des décès dans chaque département entre 2015 et 2019 sur les mêmes mois.</p>

<p>La carte est par ailleurs accompagnée <a href="https://insee.fr/fr/statistiques/4488433#consulter">sur la page de l’INSEE</a> d’autres graphiques présentant la surmortalité sous différentes formes. On peut notamment mentionner une série de cartes montrant l’évolution hebdomadaire du 2 mars au 13 avril.
Plusieurs paragraphes d’explications sont également présents, détaillants quelques chiffres et apportant des précisions. On y apprend par exemple qu’on décompte environ 22 140 décès supplémentaires sur la période étudiée par rapport à la normale.</p>

<h2 id="ce-que-la-carte-nous-apprend">Ce que la carte nous apprend</h2>

<p>Commençons par ce qui saute aux yeux, grâce aux couleurs : la surmortalité est très importante dans deux régions : l’Île de France et l’Alsace, avec des débords sur certains départements limitrophes (Doubs, Vosges, et Moselle à l’Est, Oise à proximité de l’Île de France).
<strong>La situation est particulièrement alarmante autour de Paris (les trois départements limitrophes et le Val d’Oise), alors que la capitale elle-même est un peu moins touchée.</strong>
5 départements seulement sont rouges, ils sont particulièrement impactés par la surmortalité (Val de Marne, Seine Saint Denis, Hauts de Seine, Val d’Oise, Haut-Rhin).</p>

<p>Le reste de la France est plutôt légèrement touché, avec du orange clair presque partout.</p>

<p>On note cependant quelques départements épargnés, avec une mortalité qui est même inférieure à la moyenne.
On peut imaginer plusieurs raisons à cela : une plus faible mortalité sur les routes, des variations statistiques, etc…
Côté outre-mers, la situation semble assez stable, à l’exception de Mayotte qui semble plus touchée.</p>

<p>On peut résumer les enseignements tirés à la liste suivante :</p>

<ul>
  <li>Deux régions sont particulièrement concernées : l’Alsace et l’Île de France</li>
  <li>Paris est relativement épargnée par rapport à la petite couronne (Val de Marne, Seine Saint Denis et Hauts de Seine)</li>
  <li>5 Départements sont extrêmement touchés (Val de Marne, Seine Saint Denis, Hauts de Seine, Val d’Oise, Haut-Rhin)</li>
  <li>La situation est plutôt homogène sur le reste du territoire avec une surmortalité faible mais présente</li>
  <li>Pour une quinzaine de départements, le confinement a permis un recul de la mortalité par rapport à la situation normale</li>
</ul>

<p>Plongeons maintenant dans les données afin de vérifier ces différents éléments.</p>

<p><img src="/images/content/diveinto.jpg" alt="Plongée dans les données" style="display: block; margin-left: auto; margin-right: auto; width: 50%" /></p>

<hr />

<h1 id="plongée-dans-les-données">Plongée dans les données</h1>

<p>On va maintenant vérifier si les informations communiquées par la carte de l’INSEE se confirment dans le détail des données.
On va donc reprendre tour à tour les cinq enseignements tirés plus tôt et chercher si ils tiennent bien la route à l’épreuve du détail.</p>

<ul>
  <li><strong>Deux régions sont particulièrement touchées : l’Alsace et l’Île de France</strong></li>
</ul>

<p>C’est vrai.
En ce qui concerne l’Île de France, à l’exception de la Seine-et-Marne qui affiche 61% de surmortalité (1.61), les autres départements de la région sont à plus de 74% de surmortalité (1.74), ce qui les distingue du reste de l’hexagone.
Pour l’Alsace et ses départements limitrophes, cela se confirme également, avec deux nuances : le Doubs est moins impacté que les autres avec 54% de surmortalité, il passe de justesse dans la catégorie orange sombre.
La Moselle à 61% de surmortalité est également en deça des autres départements orange sombre.</p>

<p>On entend depuis plusieurs semaines que ces deux régions sont les deux foyers principaux de l’épidémie, cette carte et les données qui l’accompagnent le confirment, rien de vraiment surprenant donc.</p>

<ul>
  <li><strong>Paris est relativement épargnée par rapport à la petite couronne</strong></li>
</ul>

<p>Malheureusement, par le biais du zoom et des couleurs, c’est là l’un des éléments qui saute le plus aux yeux lorsque l’on regarde la carte, alors que cette conclusion est assez fausse.
Voici les chiffres pour les 4 départements :</p>

<table>
  <thead>
    <tr>
      <th>Département</th>
      <th>Mortalité</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Paris</td>
      <td>1,98</td>
    </tr>
    <tr>
      <td>Val-de-Marne</td>
      <td>2,05</td>
    </tr>
    <tr>
      <td>Val-d’Oise</td>
      <td>2,10</td>
    </tr>
    <tr>
      <td>Seine-Saint-Denis</td>
      <td><strong>2,34</strong></td>
    </tr>
  </tbody>
</table>

<p>Ce qu’on remarque surtout à la lecture de ces chiffres, c’est que la Seine-Saint-Denis a une surmortalité très éloignée des trois autres départements, et que Paris est très similaire au Val-de-Marne et au Val-d’Oise.
La conclusion que nous avions tirée d’un Paris relativement épargné par rapport à la petite couronne est donc fausse, on pourrait plutôt dire que la Seine-Saint-Denis est un département particulièrement touché.</p>

<ul>
  <li><strong>5 Départements sont extrêmement touchés</strong></li>
</ul>

<p>Comme on vient de le voir, c’est plutôt faux en ce qui concerne le Val-de-Marne et le Val-d’Oise, sauf à y rajouter Paris. Si on regarde les 5 départements les plus touchés et les 5 qui les suivent, on obtient :</p>

<table>
  <thead>
    <tr>
      <th>Département</th>
      <th>Mortalité</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Haut-Rhin</td>
      <td><strong>2,48</strong></td>
    </tr>
    <tr>
      <td>Seine-Saint-Denis</td>
      <td><strong>2,34</strong></td>
    </tr>
    <tr>
      <td>Val-d’Oise</td>
      <td>2,10</td>
    </tr>
    <tr>
      <td>Val-de-Marne</td>
      <td>2,05</td>
    </tr>
    <tr>
      <td>Hauts-de-Seine</td>
      <td>2,04</td>
    </tr>
    <tr>
      <td>Paris</td>
      <td>1,98</td>
    </tr>
    <tr>
      <td>Essonne</td>
      <td>1,82</td>
    </tr>
    <tr>
      <td>Yvelines</td>
      <td>1,74</td>
    </tr>
    <tr>
      <td>Vosges</td>
      <td>1,72</td>
    </tr>
    <tr>
      <td>Bas-Rhin</td>
      <td>1,70</td>
    </tr>
  </tbody>
</table>

<p>On y voit plutôt une démarcation différente : deux départements très fortement touchés à savoir le Haut-Rhin et la Seine-Saint-Denis, quatre département fortement touchés (Val-d’Oise, Val-de-Marne, Hauts-de-Seine, Paris), l’Essonne dans une position intermédiaire, puis les départements un peu moins touchés.</p>

<ul>
  <li><strong>La situation est plutôt homogène sur le reste du territoire avec une surmortalité faible mais présente</strong></li>
</ul>

<p>La problématique ici est que les seuils choisis, de 1.0 à 1.5, comprennent à la fois des départements avec une quasi-absence de surmortalité, et des départements à la surmortalité forte.
Pour entrer dans le détail, on compte en orange clair pas moins de 30 départements avec une surmortalité inférieure à 10%, autant dire qu’il est difficile de conclure à une incidence significative du virus sur ces départements.
A tout le moins faudrait-il aller dans le détail, montrer que la mortalité a reculé par ailleurs (par exemple moins d’accidents, moins de pollution entraînant des troubles respiratoires, moins d’accidents du travail, …) pour pouvoir conclure qu’une surmortalité de 10% est significative.</p>

<p>Dans la même catégorie, on trouve le Rhône et sa surmortalité de 48%. Ce genre d’effets de seuil arrive dans la quasi-totalité des choroplètes, il est impossible de trouver un seuil évitant cet inconvénient.
Néanmoins, on mélange ici des réalités très différentes.</p>

<ul>
  <li><strong>Pour une quinzaine de départements, le confinement a permis un recul de la mortalité par rapport à la situation normale</strong></li>
</ul>

<p>Encore une fois, l’effet de seuil à 1 mélange ce qui n’est probablement qu’anomalies statistiques avec la haute-Vienne à 0.99, et des données plus surprenantes, qu’il faudrait probablement fouiller pour mieux les comprendre (Tarn-et-Garonne ou Guyane à 0.83 par exemple).</p>

<hr />

<h1 id="construction-dune-carte-alternative">Construction d’une carte alternative</h1>

<p>Lançons nous dans la construction d’une carte alternative.
Pour cela, on va énoncer les propriétés qu’on souhaite qu’elle ait, c’est à dire les messages qu’elle renverra.
Une fois les messages décidés, nous verrons quels seuils appliquer pour répondre aux mieux à nos besoins.</p>

<h2 id="les-messages-à-envoyer">Les messages à envoyer</h2>

<p>On a vu que deux départements ont une mortalité très importante : le Haut-Rhin et la Seine-Saint-Denis.
On fera donc en sorte de leur consacrer une catégorie.</p>

<ul>
  <li><strong>Mettre en avant la forte surmortalité en Haut-Rhin et Seine-Saint-Denis</strong></li>
</ul>

<p>On a ensuite vu que plusieurs départements avaient des mortalités très proches de l’habituel, soit juste au dessus, soit juste en dessous. On ne peut pas vraiment les mettre dans l’une ou l’autre des catégories (hausse ou baisse), on va donc essayer de les mettre à part.</p>

<ul>
  <li><strong>Pouvoir identifier les zones où la mortalité n’est pas très différente de d’habitude</strong></li>
</ul>

<p>Quelques rares départements enregistrent un recul net de la mortalité. Montrons les.</p>

<ul>
  <li><strong>Mettre en avant les départements où il y a un recul de la mortalité</strong></li>
</ul>

<p>Enfin, il y a différents degrés de surmortalité. Mettre ensemble des départements avec une hausse de 20% ou une hausse de 80% n’aurait pas de sens.</p>

<ul>
  <li><strong>Séparer en plusieurs catégories en fonction de la hausse de mortalité</strong></li>
</ul>

<p>Maintenant que nous sommes au clair sur les messages que l’on veut transmettre, cherchons les paramètres qui permettront de construire cette carte.</p>

<h2 id="choix-des-paramètres">Choix des paramètres</h2>

<p>On pourrait utiliser divers méthodes statistiques pour trouver “les meilleurs” seuils.
On s’expose néanmoins dans ce cas à donner l’impression que les seuils sont trop artificiels, qu’ils ont été créés spécifiquement pour tordre la réalité.
Ici, on cherche plutôt à trouver des seuils cohérents, sans pour autant les rendre artificiel, et on va donc réfléchir de manière fonctionnelle et par élimination.</p>

<ul>
  <li><strong>Pouvoir identifier les zones où la mortalité n’est pas très différente de d’habitude</strong></li>
</ul>

<p>Pour ce premier élément, on va vouloir choisir un seuil bas et un seuil haut entre lesquels on déterminera que la mortalité est “normale”.
On va vouloir centrer ces valeurs autour de 1.0 afin de ne pas donner l’impression de seuils artificiels (on ne va pas choisir 0.85/1.13 par exemple).
Sans être spécialiste de l’analyse de mortalités, une variation de plus ou moins 10% autour de la moyenne ne me semble pas très probante. On peut donc décider de place ces seuils à 0.90-1.10.
Les départements ayant une mortalité dans cette zone seront affichés dans un bleu très pâle. En effet, le blanc est plus généralement représentatif de l’absence de données que de la neutralité.</p>

<ul>
  <li><strong>Mettre en avant les départements où il y a un recul de la mortalité</strong></li>
</ul>

<p>On a déjà répondu à ce besoin avec notre seuil à 0.90 défini juste au dessus.
Les départements en dessous de ce seuil seront donc indiqués en vert afin de communiquer l’aspect positif. On gardera le rouge/orange pour les endroits où la mortalité à augmenté, comme dans la carte originelle.</p>

<ul>
  <li><strong>Mettre en avant la forte surmortalité en Haut-Rhin et Seine-Saint-Denis</strong></li>
</ul>

<p>On a vu plus haut que ces deux départements avaient des chiffres très élevés. On peut les rappeler, avec les deux départements suivants en terme de mortalité :</p>

<table>
  <thead>
    <tr>
      <th>Département</th>
      <th>Mortalité</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Haut-Rhin</td>
      <td><strong>2,48</strong></td>
    </tr>
    <tr>
      <td>Seine-Saint-Denis</td>
      <td><strong>2,34</strong></td>
    </tr>
    <tr>
      <td>Val-d’Oise</td>
      <td>2,10</td>
    </tr>
    <tr>
      <td>Val-de-Marne</td>
      <td>2,05</td>
    </tr>
  </tbody>
</table>

<p>Ici, on va choisir donc un seuil entre 2.10 (Val-d’Oise) et 2.34 (Seine-Saint-Denis). On sélectionne 2.20. C’est une valeur centrale, ronde, à peu près entre deux valeurs.</p>

<ul>
  <li>Séparer en plusieurs catégories en fonction de la hausse de mortalité</li>
</ul>

<p>Ici il y a davantage d’arbitraire. On peut choisir le nombre de couleurs et les seuils de plusieurs façons.
Les seuils existants à cette étape sont 0.90-1.10-?-2.20. J’ai choisi les seuils 1.40 et 1.70 afin d’avoir un pas de 0.30 pour les valeurs allant de 1.10 à 1.70.</p>

<h2 id="la-carte">La carte</h2>

<p>Voici le choroplèthe obtenu.</p>

<p><img src="/images/content/choroplethe.png" alt="Carte choroplèthe obtenue" style="display: block; margin-left: auto; margin-right: auto; width: 70%" /></p>

<p>La lecture de cette carte n’est pas du tout la même que celle de la carte originelle.
La première chose qui saute aux yeux, c’est que près d’un tiers des départements n’a pas vu de hausse sensible de la mortalité.
<strong>Cela ne veut pas dire que le covid n’a pas tué dans ces régions</strong>, la faible hausse pouvant être dûe à certains facteurs allant à la baisse (mortalité routière, accidents au travail, …).</p>

<p>Le second élément visible est le fait que tout l’est de la france, ainsi qu’un axe Nantes-Bruxelles, sont concernés. A l’inverse, le sud-ouest et la Bretagne sont globalement épargnés.</p>

<p>Enfin, on remarque bien que l’Alsace et la région parisienne sont particulièrement touchées, et davantage encore la Seine-Saint-Denis et le Haut-Rhin qui paient le plus lourd tribut.</p>

<hr />

<h1 id="conclusion">Conclusion</h1>

<p>Les choroplèthes sont des visualisations ingrates. Il faut nécessairement choisir des seuils, et ceux-ci ne peuvent jamais être parfaits.
Il faut donc les choisir en fonction du message que l’on cherche à faire passer pour accentuer ou atténuer certains aspects que l’on trouve peut pertinent.</p>

<p>Dans le cas de la carte de l’INSEE, le choix des seuils peut selon moi s’expliquer par deux éléments : montrer que l’essentiel de la France est impacté, même sensiblement (choix de colorer en orange tout ce qui est supérieur 1.0).
Cela amplifie le message donné par ailleurs de 22 000 morts supplémentaires en France. Le second choix compréhensible est d’utiliser des nombres simples comme seuils : 1.0, 1.5, 2.0.
Il est alors difficile de leur reprocher d’avoir joué avec les seuils pour trafiquer la perception que l’on peut avoir.</p>

<p>Ici, je suis en désaccord avec ce dernier choix car il nous fait tirer de mauvaises conclusions lors d’une lecture rapide.
Fort heureusement, les données et les textes associés à cette carte sur le site de l’INSEE ainsi que le fait qu’elle soit interactive et permette de voir les chiffres au survol d’un département.
Cela permet d’apporter nuances et informations complémentaires, ce qui n’est pour ainsi dire jamais le cas lorsque la carte est partagée sur des réseaux sociaux ou commentée sur les plateaux TV.</p>

<p><img src="/images/content/2choro.png" alt="Comparaison des deux cartes" style="display: block; margin-left: auto; margin-right: auto; width: 70%" /></p>
<figcaption>Comparaison des deux cartes</figcaption>

<hr />]]></content><author><name></name></author><category term="Data" /><category term="Visualisation" /><category term="Covid" /><summary type="html"><![CDATA[Comment faire passer différents messages via la data. Exemple au travers d'une carte publiée par l'INSEE et d'une version alternative dans le contexte du covid-19.]]></summary></entry><entry><title type="html">Python : Hériter de str et survivre</title><link href="http://ledatablog.com/python/2020/03/06/Heriter-de-str-et-survivre.html" rel="alternate" type="text/html" title="Python : Hériter de str et survivre" /><published>2020-03-06T00:00:00+00:00</published><updated>2020-03-06T00:00:00+00:00</updated><id>http://ledatablog.com/python/2020/03/06/Heriter-de-str-et-survivre</id><content type="html" xml:base="http://ledatablog.com/python/2020/03/06/Heriter-de-str-et-survivre.html"><![CDATA[<p>Python est un langage de programmation très utilisé pour la programmation d’intelligences artificielles, et pour le traitement des langues (ou NLP, qui comprend par exemple la traduction automatique, la classification de textes, …).
Il est donc très fréquent d’y utiliser des chaînes de caractères, ou <em>str</em>, un type de base du langage. Il peut devenir tentant, pour rajouter des fonctionnalités aux <em>str</em>, d’en hériter pour créer des objets plus polyvalents.
Malheureusement, c’est généralement une mauvaise idée et de nombreux problèmes difficiles à anticiper risquent de se présenter.
Qu’importe, tentons l’expérience et utilisons l’occasion pour comprendre un peu mieux certaines particularités du langage Python !</p>

<p>Ce billet est une adaptation de mon talk à la PyconFr 2019, un événement annuel qui regroupe les utilisateurs du langage Python.
Les slides de ma présentation sont <a href="https://sildar.github.io/pyconfr2019/">visibles ici</a>, et la <a href="https://www.youtube.com/watch?v=iWajitVSRNg&amp;list=PL_dGzOUQ0cyh9OPCiPXyRP9Px72SCHUZ_&amp;index=7">vidéo est sur Youtube</a>.</p>

<h1 id="lobjectif">L’objectif</h1>

<p>On souhaite créer une classe, qu’on nommera <strong>PyconStr</strong>, et qui hérite de <em>str</em> en lui rajoutant des fonctionnalités.
Pour l’occasion, on va créer une méthode <em>shout()</em> qui ajoute un point d’exclamation à notre <strong>PyconStr</strong>.
Le but sera de <strong>pouvoir enchaîner de façon transparente</strong> les appels aux fonctions standard de <em>str</em> comme <em>strip()</em> (suppression des espaces en début et fin de chaîne) ou <em>capitalize()</em> (mise en majuscule de la première lettre) <strong>et nos propres méthodes</strong>.</p>

<p>Notre <strong>PyconStr</strong> pourra prendre deux paramètres, un premier correspondant à la chaîne de caractère que l’on souhaite avoir, et un second dont on ne s’occupera pas vraiment, qui pourrait être une autre chaîne de caractère, un entier, ou quoi que ce soit d’autre.
Voici à quoi ça va ressembler :</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># Notez le str dans la définition de la classe
# indiquant que la classe hérite de str
</span><span class="k">class</span> <span class="nc">PyconStr</span><span class="p">(</span><span class="nb">str</span><span class="p">):</span>
  <span class="c1"># Magic code
</span>

<span class="n">s</span> <span class="o">=</span> <span class="n">PyconStr</span><span class="p">(</span><span class="s">" bonjour "</span><span class="p">,</span> <span class="s">"Pycon"</span><span class="p">)</span>
<span class="k">print</span><span class="p">(</span><span class="n">s</span><span class="p">)</span>
<span class="s">" bonjour "</span>
<span class="n">s</span> <span class="o">=</span> <span class="n">s</span><span class="p">.</span><span class="n">strip</span><span class="p">().</span><span class="n">shout</span><span class="p">().</span><span class="n">capitalize</span><span class="p">()</span>
<span class="k">print</span><span class="p">(</span><span class="n">s</span><span class="p">)</span>
<span class="s">"Bonjour!"</span>
</code></pre></div></div>

<p>Tout l’enjeu sera de remplacer le <em># Magic code</em> par du vrai code.</p>

<p><img src="/images/content/challenge.webp" alt="Challenge accepted!" style="display: block; margin-left: auto; margin-right: auto; width: 60%" /></p>

<hr />

<h1 id="ce-quil-faudrait-faire">Ce qu’il faudrait faire</h1>

<p>J’ai précisé dans l’introduction qu’hériter de <em>str</em> était une mauvaise idée, et plutôt que d’attendre la fin pour vous donner la <em>bonne</em> façon de faire, autant s’en débarasser tout de suite.
L’objectif est davantage de montrer ce qui ne va pas fonctionner lors de l’héritage de <em>str</em> que de discuter de la solution optimale.</p>

<p>Une bonne façon de faire, c’est d’encapsuler la <em>str</em> dans un attribut de notre classe, et d’appliquer les méthodes de <em>str</em> qui nous intéressent à cet attribut.
Voici un exemple nommé <strong>JolieStr</strong>, qui reproduit le fonctionnement souhaité plus haut, mais sans hériter de <em>str</em> :</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">JolieStr</span><span class="p">:</span>
  <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">content</span><span class="p">,</span> <span class="n">info</span><span class="p">):</span>
    <span class="c1"># on enregistre la chaîne dans un attribut _content
</span>    <span class="bp">self</span><span class="p">.</span><span class="n">_content</span> <span class="o">=</span> <span class="n">content</span>
    <span class="bp">self</span><span class="p">.</span><span class="n">_info</span> <span class="o">=</span> <span class="n">info</span>

  <span class="c1"># on "réimplémente" les méthodes standard str qui nous intéressent
</span>  <span class="k">def</span> <span class="nf">capitalize</span><span class="p">(</span><span class="bp">self</span><span class="p">):</span>
    <span class="bp">self</span><span class="p">.</span><span class="n">_content</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">_content</span><span class="p">.</span><span class="n">capitalize</span><span class="p">()</span> 
    <span class="k">return</span> <span class="bp">self</span>

  <span class="k">def</span> <span class="nf">strip</span><span class="p">(</span><span class="bp">self</span><span class="p">):</span>
    <span class="bp">self</span><span class="p">.</span><span class="n">_content</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">_content</span><span class="p">.</span><span class="n">strip</span><span class="p">()</span>
    <span class="k">return</span> <span class="bp">self</span>
	
  <span class="c1"># on rajoute notre shout()
</span>  <span class="k">def</span> <span class="nf">shout</span><span class="p">(</span><span class="bp">self</span><span class="p">):</span>
    <span class="bp">self</span><span class="p">.</span><span class="n">_content</span> <span class="o">=</span> <span class="bp">self</span><span class="p">.</span><span class="n">_content</span> <span class="o">+</span> <span class="s">'!'</span>
    <span class="k">return</span> <span class="bp">self</span>

  <span class="c1"># on renseigne __repr__ pour que lors d'un print
</span>  <span class="c1"># seul l'attribut _content soit affiché
</span>  <span class="k">def</span> <span class="nf">__repr__</span><span class="p">(</span><span class="bp">self</span><span class="p">):</span>  
    <span class="k">return</span> <span class="bp">self</span><span class="p">.</span><span class="n">_content</span>


<span class="n">s</span> <span class="o">=</span> <span class="n">JolieStr</span><span class="p">(</span><span class="s">" bonjour "</span><span class="p">,</span> <span class="s">"Pycon"</span><span class="p">)</span>
<span class="k">print</span><span class="p">(</span><span class="n">s</span><span class="p">)</span>
<span class="s">" bonjour "</span>
<span class="n">s</span> <span class="o">=</span> <span class="n">s</span><span class="p">.</span><span class="n">strip</span><span class="p">().</span><span class="n">shout</span><span class="p">().</span><span class="n">capitalize</span><span class="p">()</span>
<span class="k">print</span><span class="p">(</span><span class="n">s</span><span class="p">)</span>
<span class="s">"Bonjour!"</span>
</code></pre></div></div>

<p>L’inconvénient est ici principalement qu’il faut réimplémenter toutes les méthodes standard de <em>str</em> pour bien les appliquer au bon attribut.
On retourne systématiquement <em>self</em> dans nos méthodes afin de pouvoir les enchaîner, et si jamais il est fait appel à une méthode standard de <em>str</em> qu’on a pas pris la peine de réimplémenter, une erreur se produira.</p>

<p>Il existe quelques options pour éviter ces problèmes, dont certaines seront évoquées plus loin.
Mais laissons de côté cette <strong>JolieStr</strong> et concentrons nous sur l’implémentation de la <strong>PyconStr</strong> héritant directement de <em>str</em>.</p>

<hr />

<h1 id="basicstr-un-monde-merveilleux-ou-tout-est-simple">BasicStr, un monde merveilleux ou tout est simple</h1>

<p>Le premier réflexe qu’aurait un développeur ayant à créer une classe héritant de <em>str</em> serait probablement de s’y essayer comme si tout allait se passer au mieux.
Sa classe, qu’on appelera <strong>BasicStr</strong>, pourrait ressembler à ça :</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">BasicStr</span><span class="p">(</span><span class="nb">str</span><span class="p">):</span>
  <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">content</span><span class="p">,</span> <span class="n">info</span><span class="p">):</span>
    <span class="c1"># on fait appel à l'init de str
</span>    <span class="c1"># en se disant qu'en lui envoyant la chaîne
</span>    <span class="c1"># il va créer une str directement
</span>    <span class="nb">super</span><span class="p">().</span><span class="n">__init__</span><span class="p">(</span><span class="n">content</span><span class="p">)</span>
    <span class="bp">self</span><span class="p">.</span><span class="n">_info</span> <span class="o">=</span> <span class="n">info</span>


<span class="n">s</span> <span class="o">=</span> <span class="n">BasicStr</span><span class="p">(</span><span class="s">" bonjour "</span><span class="p">,</span> <span class="s">"Pycon"</span><span class="p">)</span>
<span class="k">print</span><span class="p">(</span><span class="n">s</span><span class="p">)</span>
</code></pre></div></div>

<p>Hélas, ces quelques lignes de code ne fonctionnent absolument pas.</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Traceback (most recent call last):
File "basicstr.py", line 6, in module
   s = BasicStr(" bonjour ",  "Pycon")
TypeError: decoding str is not supported
</code></pre></div></div>

<p><img src="/images/content/waitwhat.webp" alt="I don't get it!" style="display: block; margin-left: auto; margin-right: auto; width: 60%" /></p>

<p>L’erreur est un peu cryptique, et lorsque l’on essaye de la débugger, on se rend compte que le programme plante avant même d’arriver dans la méthode <em>__init__()</em> !</p>

<p>En <a href="https://docs.python.org/3/reference/datamodel.html#object.__new__">fouillant un peu</a> on réalise qu’il existe une méthode <em>__new__()</em> qui est appelée avant <em>__init__()</em> et sert à instancier les objets, notamment les types de base dont <em>str</em> fait partie.
On trouve la défintion suivante dans la documentation, bien utile :</p>

<blockquote>
  <p>object.__init__(self[, …]):</p>

  <p>Called after the instance has been created (by __new__()), but before it is returned to the caller.</p>
</blockquote>

<blockquote>
  <p>object.__new__(cls[, …]):</p>

  <p>__new__() is intended mainly to allow subclasses of immutable types (like int, str, or tuple) to customize instance creation. It is also commonly overridden in custom metaclasses in order to customize class creation.</p>
</blockquote>

<h1 id="newstr-où-lon-a-appris-de-nos-erreurs">NewStr, où l’on a appris de nos erreurs</h1>

<p>Après avoir lu la documentation, la solution semble claire : il faut faire appel à <em>__new__()</em>.
Sa syntaxe est un peu différente de <em>__init__()</em>, mais on s’y retrouve vite, et voici à quoi ressemblerait une <strong>NewStr</strong> :</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">NewStr</span><span class="p">(</span><span class="nb">str</span><span class="p">):</span>
  <span class="k">def</span> <span class="nf">__new__</span><span class="p">(</span><span class="n">cls</span><span class="p">,</span> <span class="n">content</span><span class="p">,</span> <span class="n">info</span><span class="p">):</span>
    <span class="n">obj</span> <span class="o">=</span> <span class="nb">super</span><span class="p">().</span><span class="n">__new__</span><span class="p">(</span><span class="n">cls</span><span class="p">,</span> <span class="n">content</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">obj</span>

  <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">content</span><span class="p">,</span> <span class="n">info</span><span class="p">):</span>
    <span class="nb">super</span><span class="p">().</span><span class="n">__init__</span><span class="p">()</span>
    <span class="bp">self</span><span class="p">.</span><span class="n">_info</span> <span class="o">=</span> <span class="n">info</span>

  <span class="k">def</span> <span class="nf">shout</span><span class="p">(</span><span class="bp">self</span><span class="p">):</span>
    <span class="k">return</span> <span class="bp">self</span> <span class="o">+</span> <span class="s">"!"</span>


<span class="n">s</span> <span class="o">=</span> <span class="n">NewStr</span><span class="p">(</span><span class="s">"bonjour"</span><span class="p">,</span> <span class="s">"Pycon"</span><span class="p">)</span>
<span class="k">print</span><span class="p">(</span><span class="n">s</span><span class="p">)</span>
<span class="s">"bonjour"</span>
<span class="c1"># upper() fonctionne sans que l'on ai eu besoin de l'implémenter
</span><span class="k">print</span><span class="p">(</span><span class="n">s</span><span class="p">.</span><span class="n">upper</span><span class="p">())</span>
<span class="s">"Bonjour"</span>
<span class="k">print</span><span class="p">(</span><span class="n">s</span><span class="p">.</span><span class="n">shout</span><span class="p">())</span>
<span class="s">"bonjour!"</span>
</code></pre></div></div>

<p>A première vue, tout fonctionne comme prévu ! Mais dès qu’on essaye d’enchaîner les méthodes…</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">s</span> <span class="o">=</span> <span class="n">NewStr</span><span class="p">(</span><span class="s">"bonjour"</span><span class="p">,</span> <span class="s">"Pycon"</span><span class="p">)</span>
<span class="k">print</span><span class="p">(</span><span class="n">s</span><span class="p">.</span><span class="n">shout</span><span class="p">().</span><span class="n">shout</span><span class="p">())</span>
</code></pre></div></div>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Traceback (most recent call last):
File "newstr.py", line 6, in module
  print(s.shout().shout())
AttributeError: 'str' object has no attribute 'shout'
</code></pre></div></div>

<p><img src="/images/content/knewit2.webp" alt="I knew it!" style="display: block; margin-left: auto; margin-right: auto; width: 60%" /></p>

<p>L’erreur est cette fois-ci moins crytique : on nous dit que <em>str</em> n’a pas de méthode <em>shout()</em>, et c’est logique ! Notre méthode <em>shout()</em>, lorsqu’elle concatène le “!” renvoie en effet une chaîne de caractères.
Pas de panique, la solution est simple, il suffit de faire en sorte que <em>shout()</em> renvoie une NewStr à la place.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">NewStr</span><span class="p">(</span><span class="nb">str</span><span class="p">):</span>
  <span class="k">def</span> <span class="nf">__new__</span><span class="p">(</span><span class="n">cls</span><span class="p">,</span> <span class="n">content</span><span class="p">,</span> <span class="n">info</span><span class="p">):</span>
    <span class="n">obj</span> <span class="o">=</span> <span class="nb">super</span><span class="p">().</span><span class="n">__new__</span><span class="p">(</span><span class="n">cls</span><span class="p">,</span> <span class="n">content</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">obj</span>

  <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">content</span><span class="p">,</span> <span class="n">info</span><span class="p">):</span>
    <span class="nb">super</span><span class="p">().</span><span class="n">__init__</span><span class="p">()</span>
    <span class="bp">self</span><span class="p">.</span><span class="n">_info</span> <span class="o">=</span> <span class="n">info</span>

  <span class="k">def</span> <span class="nf">shout</span><span class="p">(</span><span class="bp">self</span><span class="p">):</span>
    <span class="k">return</span> <span class="n">NewStr</span><span class="p">(</span><span class="bp">self</span> <span class="o">+</span> <span class="s">"!"</span><span class="p">,</span> <span class="bp">self</span><span class="p">.</span><span class="n">_info</span><span class="p">)</span>

<span class="n">s</span> <span class="o">=</span> <span class="n">NewStr</span><span class="p">(</span><span class="s">"bonjour"</span><span class="p">,</span> <span class="s">"Pycon"</span><span class="p">)</span>
<span class="k">print</span><span class="p">(</span><span class="n">s</span><span class="p">.</span><span class="n">shout</span><span class="p">().</span><span class="n">shout</span><span class="p">())</span>
<span class="s">"bonjour!!"</span>
</code></pre></div></div>
<p><img src="/images/content/excited.webp" alt="Happy face!" style="display: block; margin-left: auto; margin-right: auto; width: 60%" /></p>

<p>Malheureusement, les méthodes de <em>str</em> retournent toujours des <em>str</em>, et pas des <strong>NewStr</strong>, ce qui empêche l’enchaînement de méthodes str-&gt;NewStr :</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">print</span><span class="p">(</span><span class="n">s</span><span class="p">.</span><span class="n">upper</span><span class="p">().</span><span class="n">shout</span><span class="p">())</span>
</code></pre></div></div>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Traceback (most recent call last):
File "newstr.py", line 6, in module
  print(s.upper().shout())
AttributeError: 'str' object has no attribute 'shout'
</code></pre></div></div>

<p><img src="/images/content/disappointed.webp" alt="Sad face!" style="display: block; margin-left: auto; margin-right: auto; width: 60%" /></p>

<p>Il va donc falloir intercepter les méthodes de <em>str</em> pour transformer le type de leurs retours !</p>

<h1 id="interceptstr-où-on-attrape-les-résultats-au-vol">InterceptStr, où on attrape les résultats au vol</h1>

<p>L’idée consiste à s’apercevoir, lors des appels de méthodes sur notre objet, si la méthode appelée dépend de <em>str</em>, ou si elle est implémentée “chez nous” dans <strong>InterceptStr</strong>.
Heureusement, une méthode existe pour ça, il s’agit de <em>__getattribute__()</em> :</p>

<blockquote>
  <p>object.__getattribute__(self, name):</p>

  <p>Called unconditionally to implement attribute accesses for instances of the class.</p>
</blockquote>

<p>Côté implémentation, c’est un peu plus complexe, et on va faire ça en deux temps.
Notre classe <strong>InterceptStr</strong> va donc implémenter <em>__getattribute__()</em>, qui indiquera le nom de la méthode appelée.
Si la méthode appartient à la classe <em>str</em>, ce qu’on peut vérifier en regardant si elle apparaît dans <em>dir(str)</em> (une fonction standard servant à vérifier tous les attributs accessibles de l’instance passée en paramètre), on… verra ce qu’on fait un peu plus tard !
Dans le cas contraire, c’est que la méthode appartient à notre classe <strong>InterceptStr</strong>, et on se contente de poursuivre le chemin classique en faisant appel à <em>super().__getattribute__()</em>.</p>

<p>On obtient la classe (incomplète!) suivante :</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">InterceptStr</span><span class="p">(</span><span class="nb">str</span><span class="p">):</span>

  <span class="k">def</span> <span class="nf">__new__</span><span class="p">(</span><span class="n">cls</span><span class="p">,</span> <span class="n">content</span><span class="p">,</span> <span class="n">info</span><span class="p">):</span>
    <span class="n">obj</span> <span class="o">=</span> <span class="nb">super</span><span class="p">().</span><span class="n">__new__</span><span class="p">(</span><span class="n">cls</span><span class="p">,</span> <span class="n">content</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">obj</span>

  <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">content</span><span class="p">,</span> <span class="n">info</span><span class="p">):</span>
    <span class="nb">super</span><span class="p">().</span><span class="n">__init__</span><span class="p">()</span>
    <span class="bp">self</span><span class="p">.</span><span class="n">_info</span> <span class="o">=</span> <span class="n">info</span>

  <span class="k">def</span> <span class="nf">__getattribute__</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">name</span><span class="p">):</span>
    <span class="k">if</span> <span class="n">name</span> <span class="ow">in</span> <span class="nb">dir</span><span class="p">(</span><span class="nb">str</span><span class="p">):</span>
      <span class="c1"># on à affaire à une méthode de str
</span>      <span class="k">return</span> <span class="c1"># TODO !
</span>    <span class="k">else</span><span class="p">:</span>
      <span class="c1"># on suit le chemin normal en laissant getattribute gérer.
</span>      <span class="k">return</span> <span class="nb">super</span><span class="p">().</span><span class="n">__getattribute__</span><span class="p">(</span><span class="n">name</span><span class="p">)</span>

    <span class="k">def</span> <span class="nf">shout</span><span class="p">(</span><span class="bp">self</span><span class="p">):</span>
      <span class="k">return</span> <span class="n">InterceptStr</span><span class="p">(</span><span class="bp">self</span> <span class="o">+</span> <span class="s">"!"</span><span class="p">,</span> <span class="bp">self</span><span class="p">.</span><span class="n">_info</span><span class="p">)</span>
</code></pre></div></div>

<p>Dans notre return, on aimerait bien pouvoir directement appeler la méthode concernée, le problème est que dans <em>__getattribute__()</em>, nous n’avons accès qu’au nom de la méthode, et pas à ses arguments.
Il va donc falloir ruser et passer par une fonction annexe qui elle acceptera les arguments.
Elle se chargera alors d’appliquer la méthode à partir de son nom et des arguments grâce à fonction standard <em>getattr()</em>.
On s’assurera juste du type de valeur retournée par la méthode executée : si c’est un <em>str</em>, on le transformera en <strong>InterceptStr</strong>, sinon on lui laissera son type par défaut.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">applymethod</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">funcname</span><span class="p">,</span> <span class="o">*</span><span class="n">args</span><span class="p">,</span> <span class="o">**</span><span class="n">kwargs</span><span class="p">):</span>
  <span class="n">value</span> <span class="o">=</span> <span class="nb">getattr</span><span class="p">(</span><span class="nb">super</span><span class="p">(),</span> <span class="n">funcname</span><span class="p">)(</span><span class="o">*</span><span class="n">args</span><span class="p">,</span> <span class="o">**</span><span class="n">kwargs</span><span class="p">)</span>
  <span class="k">if</span> <span class="nb">isinstance</span><span class="p">(</span><span class="n">value</span><span class="p">,</span> <span class="nb">str</span><span class="p">):</span>
    <span class="k">return</span> <span class="n">InterceptStr</span><span class="p">(</span><span class="n">value</span><span class="p">,</span> <span class="bp">self</span><span class="p">.</span><span class="n">_info</span><span class="p">)</span>
  <span class="k">return</span> <span class="n">value</span>
</code></pre></div></div>

<p>Il n’y a alors plus qu’à utiliser <em>applymethod()</em> dans notre <em>__getattribute__()</em>.</p>

<p>Dernière subtilité, <em>__getattribute__()</em> doit absolument retourner une fonction ou une méthode, et pas une valeur !
Plutôt que de retourner directement le résultat de <em>applymethod()</em>, on va donc retourner une fonction créée à la volée avec les bons paramètres.
On va utiliser pour cela <em>functools.partial()</em>, qui est un module standard de Python.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code>  <span class="k">def</span> <span class="nf">__getattribute__</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">name</span><span class="p">):</span>
    <span class="k">if</span> <span class="n">name</span> <span class="ow">in</span> <span class="nb">dir</span><span class="p">(</span><span class="nb">str</span><span class="p">):</span>
      <span class="c1"># on à affaire à une méthode de str
</span>      <span class="k">return</span> <span class="n">functools</span><span class="p">.</span><span class="n">partial</span><span class="p">(</span><span class="bp">self</span><span class="p">.</span><span class="n">applyfunction</span><span class="p">,</span> <span class="n">name</span><span class="p">)</span>
    <span class="k">else</span><span class="p">:</span>
      <span class="c1"># on suit le chemin normal en laissant getattribute gérer.
</span>      <span class="k">return</span> <span class="nb">super</span><span class="p">().</span><span class="n">__getattribute__</span><span class="p">(</span><span class="n">name</span><span class="p">)</span>
</code></pre></div></div>

<h1 id="pyconstr-la-solution-complète">PyconStr, la solution complète</h1>

<p>Nous arrivons au bout du chemin. On a résolu presque tous les problèmes, et on a une classe <strong>PyconStr</strong> qui se comporte comme on le souhaite :</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">class</span> <span class="nc">PyconStr</span><span class="p">(</span><span class="nb">str</span><span class="p">):</span>

  <span class="k">def</span> <span class="nf">__new__</span><span class="p">(</span><span class="n">cls</span><span class="p">,</span> <span class="n">content</span><span class="p">,</span> <span class="n">info</span><span class="p">):</span>
    <span class="n">obj</span> <span class="o">=</span> <span class="nb">super</span><span class="p">().</span><span class="n">__new__</span><span class="p">(</span><span class="n">cls</span><span class="p">,</span> <span class="n">content</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">obj</span>

  <span class="k">def</span> <span class="nf">__init__</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">content</span><span class="p">,</span> <span class="n">info</span><span class="p">):</span>
    <span class="nb">super</span><span class="p">().</span><span class="n">__init__</span><span class="p">()</span>
    <span class="bp">self</span><span class="p">.</span><span class="n">_info</span> <span class="o">=</span> <span class="n">info</span>

  <span class="k">def</span> <span class="nf">applyfunction</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">funcname</span><span class="p">,</span> <span class="o">*</span><span class="n">args</span><span class="p">,</span> <span class="o">**</span><span class="n">kwargs</span><span class="p">):</span>
    <span class="n">value</span> <span class="o">=</span> <span class="nb">getattr</span><span class="p">(</span><span class="nb">super</span><span class="p">(),</span> <span class="n">funcname</span><span class="p">)(</span><span class="o">*</span><span class="n">args</span><span class="p">,</span> <span class="o">**</span><span class="n">kwargs</span><span class="p">)</span>
    <span class="k">if</span> <span class="nb">isinstance</span><span class="p">(</span><span class="n">value</span><span class="p">,</span> <span class="nb">str</span><span class="p">):</span>
      <span class="k">return</span> <span class="n">PyconStr</span><span class="p">(</span><span class="n">value</span><span class="p">,</span> <span class="bp">self</span><span class="p">.</span><span class="n">_info</span><span class="p">)</span>
    <span class="k">return</span> <span class="n">value</span>

  <span class="k">def</span> <span class="nf">__getattribute__</span><span class="p">(</span><span class="bp">self</span><span class="p">,</span> <span class="n">name</span><span class="p">,</span> <span class="o">*</span><span class="n">args</span><span class="p">,</span> <span class="o">**</span><span class="n">kwargs</span><span class="p">):</span>
    <span class="k">if</span> <span class="n">name</span> <span class="ow">in</span> <span class="nb">dir</span><span class="p">(</span><span class="nb">str</span><span class="p">):</span>
	  <span class="c1"># on à affaire à une méthode de str
</span>      <span class="k">return</span> <span class="n">functools</span><span class="p">.</span><span class="n">partial</span><span class="p">(</span><span class="bp">self</span><span class="p">.</span><span class="n">applyfunction</span><span class="p">,</span> <span class="n">name</span><span class="p">)</span>
    <span class="k">else</span><span class="p">:</span>
	  <span class="c1"># on suit le chemin normal en laissant getattribute gérer.
</span>      <span class="k">return</span> <span class="nb">super</span><span class="p">().</span><span class="n">__getattribute__</span><span class="p">(</span><span class="n">name</span><span class="p">)</span>

  <span class="k">def</span> <span class="nf">shout</span><span class="p">(</span><span class="bp">self</span><span class="p">):</span>
    <span class="k">return</span> <span class="n">PyconStr</span><span class="p">(</span><span class="bp">self</span> <span class="o">+</span> <span class="s">"!"</span><span class="p">,</span> <span class="bp">self</span><span class="p">.</span><span class="n">_info</span><span class="p">)</span>
</code></pre></div></div>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">s</span> <span class="o">=</span> <span class="n">PyconStr</span><span class="p">(</span><span class="s">" bonjour "</span><span class="p">,</span> <span class="s">"Pycon"</span><span class="p">)</span>
<span class="k">print</span><span class="p">(</span><span class="n">s</span><span class="p">)</span>
<span class="s">" bonjour "</span>
<span class="n">s</span> <span class="o">=</span> <span class="n">s</span><span class="p">.</span><span class="n">strip</span><span class="p">().</span><span class="n">shout</span><span class="p">().</span><span class="n">capitalize</span><span class="p">()</span>
<span class="k">print</span><span class="p">(</span><span class="n">s</span><span class="p">)</span>
<span class="s">"Bonjour!"</span>
</code></pre></div></div>

<p><img src="/images/content/done.gif" alt="Well done!" style="display: block; margin-left: auto; margin-right: auto; width: 60%" /></p>

<h1 id="lheure-du-bilan">L’heure du bilan</h1>

<p>Réimplémenter quelques méthodes comme vu avec <strong>JolieStr</strong> pouvait sembler laborieux, mais notre expérimentation d’héritage de <em>str</em> s’avère finalement bien plus complexe !</p>

<p>Au final, on aura vu quatre fonctions qui peuvent s’avérer très utiles :</p>

<ol>
  <li><em>__new__()</em> pour l’initialisation des objets immutables</li>
  <li><em>__getattribute__()</em> pour intercepter les méthodes</li>
  <li><em>getattr()</em> pour appliquer une méthode à partir de son nom</li>
  <li><em>functools.apply()</em> pour fixer un paramètre d’une fonction et retourner une nouvelle fonction</li>
</ol>

<p>Cette expérimentation a pour origine mon envie naïve d’hériter de str, et n’ayant trouvé comme plus simple explication à mes problèmes que <a href="https://stackoverflow.com/a/33272874">ce post StackOverflow</a>,
j’ai décidé de creuser et d’en faire un talk à la PyconFr 2019, un événement que j’apprécie particulièrement et que je conseille à tous les utilisateurs de Python !</p>]]></content><author><name></name></author><category term="Python" /><summary type="html"><![CDATA[Hériter de str en Python est en règle générale une mauvaise idée : mieux vaut encapsuler. Qu'importe, lançons-nous dans l'aventure et voyons ce qu'il en retourne.]]></summary></entry><entry><title type="html">Les 5 étapes d’un projet d’Intelligence Artificielle</title><link href="http://ledatablog.com/data/ia/2020/01/16/5-etapes-projet-data.html" rel="alternate" type="text/html" title="Les 5 étapes d’un projet d’Intelligence Artificielle" /><published>2020-01-16T00:00:00+00:00</published><updated>2020-01-16T00:00:00+00:00</updated><id>http://ledatablog.com/data/ia/2020/01/16/5-etapes-projet-data</id><content type="html" xml:base="http://ledatablog.com/data/ia/2020/01/16/5-etapes-projet-data.html"><![CDATA[<p>Le développement d’un algorithme d’intelligence artificielle, qu’il s’agisse de traitement des langues, d’analyse d’images, de classification ou de prédiction, répond à des exigences similaires à celles d’un développement informatique classique.
Il diffère néanmoins par une estimation de la faisabilité souvent moins robuste et un temps de construction souvent plus long et plus difficile à prédire précisément.</p>

<p>Qu’ils soient entrepris en interne ou pour le compte d’un client, la plupart des projets d’IA peuvent suivre un plan en cinq étapes, de l’analyse du besoin à l’exploitation.</p>

<p>Avant de décrire ces cinq étapes, faisons un détour par un cas trop fréquemment rencontré, le projet en une unique étape.</p>

<h1 id="le-projet-en-1-étape-ou-la-meilleure-façon-de-planter-un-projet">Le projet en 1 étape, ou la meilleure façon de planter un projet</h1>

<p>Qui s’imaginerait donner à un excellent cuisinier des ingrédients dont il ne connaît ni la provenance ni la qualité, une plaque de cuisson au gaz alors qu’il n’utilise que l’électrique et des ustensiles exotiques, tout en “l’aidant” en lui fournissant une recette dirigiste dont il ne pourra pas s’écarter, et espérer dans le même temps obtenir un plat d’exception ?</p>

<p>Étrangement, il est fréquent pour les informaticiens d’être confrontés à cette situation avec des cahiers des charges techniques très précis, dont les méthodes et outils sont imposés, mais dont les objectifs finaux ne peuvent être devinés qu’entre les lignes. Si certains projet simples peuvent parfois réussir avec cette approche, les projets d’IA, plus sensibles, y échouent presque systématiquement.</p>

<p>Le projet en une étape consiste à faire intervenir le spécialiste en développement d’IA en lui fournissant une vue très superficielle de la problématique (“nous devons faire augmenter telle valeur”), et en lui expliquant par quel moyen il doit résoudre le problème (“j’ai entendu dire que les RNN étaient très efficaces, je veux que vous les testiez sur ce cas d’usage”) et avec quelles données. Il n’a pas à comprendre, simplement à faire.</p>

<p>Une personne à qui vous confiez la tâche de manipuler des données complexes, d’architecturer des réseaux de neurones innovants et d’évaluer précisément leurs résultats doit avoir l’intelligence nécessaire à la compréhension du problème que vous tentez de résoudre et à la sélection des outils les plus appropriés.</p>

<p>Les projets d’Intelligences Artificielles sont encore plus sensibles à ce besoin d’informations : les données d’entrées sont souvent complexes et peu documentées, leur variété sous-estimée ; les objectifs finaux pas toujours clairs même pour le donneur d’ordres et les outils très rarement maîtrisés par le demandeur.</p>

<p>Le projet en 1 étape n’aboutit que rarement. Parfois l’approche choisie ne fonctionnera pas, sans que personne ne comprenne vraiment pourquoi (“normalement ça aurait dû fonctionner”). Parfois, malgré de bons résultats, l’IA ne sera pas utilisée (“la solution temporaire mise en place le temps que le projet aboutisse est finalement peu coûteuse et efficace”). Pire, parfois elle sera utilisée malgré des biais non identifiés, une performance mal évaluée, menant à la fois à un effet déceptif sur les technologies employées (“L’IA c’est du vent”) et à un risque important (utilisation contre-productive).</p>

<h1 id="les-5-étapes-dun-projet-réussi">Les 5 étapes d’un projet réussi</h1>

<p>Si un projet peut généralement être résumé à trois étapes : étude, construction et exploitation, on se propose ici de le découper en cinq : analyse du besoin, analyse et préparation des données, construction d’une baseline, construction et évaluation de l’algorithme, et enfin bilans et clôture.</p>

<p><img src="/images/content/5steps.png" alt="Les 5 étapes décrites dans ce post" style="display: block; margin-left: auto; margin-right: auto; width: 80%" /></p>

<p>Ces étapes sont conçues pour permettre une sortie “sans regrets” à la fin de chacune d’entre elle, dans l’objectif de minimiser les pertes en cas d’échec et de pouvoir capitaliser sur l’expérience acquise en cas de succès.</p>

<h2 id="1-analyser-le-besoin">1. Analyser le besoin</h2>

<p>Comme pour tout projet, l’étape d’analyse est très souvent la plus négligée, alors qu’il s’agit de l’étape la plus critique. Bien comprendre un problème, c’est déjà le résoudre à moitié.</p>

<p>Cela inclut les raisons pour lesquelles le besoin existe et en quoi il n’est pas satisfait aujourd’hui, les tentatives précédentes pour y répondre, la façon dont il est traité aujourd’hui, les différents acteurs qui sont intervenus, interviennent et interviendront dessus, …
C’est aussi la délimitation des données et cas d’usages concernés par le projet.
C’est enfin la définition de métriques claires sur lesquelles le succès ou l’échec du projet pourra être évalué.</p>

<p>Ce n’est qu’à l’issue de cette étape que sont réalisables les estimations de faisabilité et de temps nécessaire au projet. L’ensemble des informations récoltées à cette étape doit faire l’objet d’un rapport listant notamment les livrables attendus et les risques anticipés.</p>

<h2 id="2-préparer-les-données">2. Préparer les données</h2>

<p>Il est très fréquent que la qualité et le volume de données disponibles soient surestimés par les donneurs d’ordre.
L’étape de préparation des données, indispensable de toute manière pour chaque projet data, est l’occasion de vérifier l’essentiel des prérequis exposés dans l’expression de besoin.
L’analyse statistique des données permettra ainsi de valider la fiabilité, de lever les doutes sur la faisabilité, d’exposer les imprécisions et les biais qui risquent d’être posés en aval, de s’assurer que l’intégralité des cas d’usages sont couverts par la donnée.</p>

<p>C’est un moment sur lequel il est facile de passer trop rapidement : les étapes intéressantes se trouvent juste après et tout le monde a hâte d’obtenir des premiers résultats tangibles.
Or, une analyse froide avant l’obtention de tout résultat permet d’anticiper la plupart des problèmes, de les prévenir et de vérifier lors des étapes suivantes si ces problèmes surviennent ou non.
On est alors sur une pente ascendante : prudence et alertes en début de projet, levée des doutes et résultats certifiés en fin de projet.
Le risque d’une analyse trop rapide est d’engendrer au contraire une pente descendante : engouement en début de projet, premiers résultats prometteurs suivis de la mise en évidence de tout un tas de biais tempérant largement les bons résultats.</p>

<p>Un projet réussi mené avec une pente ascendante laisse une bonne impression, un sentiment de maîtrise tout au long du projet, et l’assurance de résultats solides.
Un même projet aux résultats identiques mené avec une pente descendante laisse quant à lui planer le doute sur la fiabilité et laisse craindre l’existence de biais supplémentaires non identifiés, menant à une défiance importante et à un risque de non adoption de la solution.</p>

<p>Malheureusement, pour l’exécutant, la pente descendante est le pari le plus rentable à court terme : l’obtention de premiers résultats rapides, même s’il ne sont pas fiables, encourage les donneurs d’ordre à poursuivre le projet, tandis que la levée des incertitudes tôt dans le projet peut mener à un abandon prématuré.
Sur le long terme néanmoins, il est évident que la mémoire d’un projet ascendant encouragera le renouvellement de projets d’IA, tandis qu’un projet descendant ne sera probablement pas reconduit.</p>

<p>L’analyse des données doit venir confronter les attendus de l’expression de besoins en présentant de nouveaux risques non anticipés ou au contraire en validant la qualité attendue de la donnée à disposition.</p>

<p>Un bon moyen pour ne pas abandonner trop tôt un projet pour lequel des incertitudes planent consiste à constuire une baseline, un premier algorithme simpliste développé en quelques jours, qui permette de lever la plupart des craintes soulevées lors de la préparation des données. C’est d’ailleurs une étape qu’il est bon d’inclure dans tout projet d’IA.</p>

<h2 id="3-construire-une-baseline">3. Construire une baseline</h2>

<p>Construire une baseline correspond à mettre en place un algorithme simple développé en quelques jours dont l’objectif est de vérifier d’une part la faisabilité globale du projet, et d’autre part à lever une partie des biais des données qui ont pu être identifiés plus tôt.
Il permet également de s’assurer que les données ont été correctement préparées et qu’elles sont suffisantes.
À l’issue de cette phase, plusieurs cas de figure peuvent se présenter :</p>

<ul>
  <li>Des biais importants sont détectés dans les données, et il paraît compliqué de passer outre.</li>
  <li>La baseline donne des scores extrêmement faibles, laissant penser que la faisabilité du projet a été surestimée.</li>
  <li>La baseline obtient des résultats extrêmement élevés, il n’est donc pas nécessaire de développer un algorithme complexe.</li>
  <li>La baseline donne des résultats intermédiaires, insuffisants pour répondre aux besoins du projet.</li>
</ul>

<p>Dans le premier cas, c’est à dire l’apparition ou la confirmation de biais importants, il est nécessaire de retravailler sur la donnée. En récupérer davantage, mieux la nettoyer, réevaluer le besoin afin de redéfinir le champ d’application, voire reporter le projet le temps d’avoir des données propres.</p>

<p>Dans le second cas, à savoir une baseline donnant des scores très faibles, le risque est que l’algorithme le plus efficace du monde ne parvienne pasnon plus à obtenir des résultats permettant de répondre au besoin. Une fois encore, il est alors nécessaire de rediscuter du besoin afin de s’attaquer potentiellement à un sous-problème. S’il n’est pas impossible de continuer malgré tout le projet, les risques de ne pas aboutir sont élevés.</p>

<p>Dans le troisème cas, où la baseline obtient des scores très élevés, il est possible de raccourcir le projet en sautant l’étape 4 et en passant directement à l’analyse et à la rédaction des rapports. S’il est décevant de devoir ignorer la partie la plus intéressante, celle du développement d’IA, les apports espérés ne valent certainement pas le temps qui y serait passé, sauf à compter sur des avantages connexes (familiarisation avec un technologie, communication, …).</p>

<p>Enfin, le dernier cas est celui que l’on espère, qui conforte l’idée que le problème est solutionnable tout en ayant permis de lever des doutes sur les défauts éventuels de la donnée.</p>

<p>Dans tous les cas, cette étape est l’occasion de mettre à jour le rapport d’analyse des données.</p>

<h2 id="4-développer-lalgorithme-et-lévaluer">4. Développer l’algorithme et l’évaluer</h2>

<p>Il s’agit ici de la partie réellement intéressante pour le développeur d’intelligence artificielle. À cette étape, la plupart des craintes ont pu être levées, et la seule incertitude restante est la marge de progression entre la baseline et l’algorithme d’intelligence artificielle.
Cette étape peut représenter un temps conséquent d’autant plus qu’elle doit contenir une phase d’analyse précise des résultats montrant les forces et les faiblesses du système mis en place.</p>

<p>Elle aboutie à la rédaction d’un rapport technique, plus ou moins exhaustif selon les attentes.</p>

<h2 id="5-rédiger-un-bilan">5. Rédiger un bilan</h2>

<p>Cette dernière étape, comme la première, est souvent trop négligée.
Or, un algorithme qui fonctionne parfaitement à la livraison peut tout à fait dériver peu à peu et baisser progressivement en performance.</p>

<p>L’une des principales causes potentielles à cette dérive est l’évolution des données : leur distribution change, leur définition même parfois.
Pour pouvoir dans le futur faire évoluer l’algorithme, il faut avant tout des rapports fonctionnels : quel problème devait être résolu, dans quelles conditions et sur quelles données ?
Comment a-t-il été résolu, avec quelle efficacité et quelles faiblesses ?
Comment la solution sera-t-elle utilisée, sous quelles contraintes ?</p>

<p>La documentation techique, bien qu’utile, est beaucoup moins sensible : son absence n’entraînera que des délais de mise à jour plus longs tandis que l’absence de documentation fonctionnelle risque de conduire la mise à jour à tomber dans les pièges soigneusement évités lors du projet initial.</p>

<h1 id="conclusion">Conclusion</h1>

<p>Les projets visant à construire une intelligence artificielle sont souvent risqués : les résultats sont incertains, la qualité des données quasi-systématiquement surestimée, les besoins pas toujours correctement définis.
Avoir une planification robuste avec des étapes permettant des sorties prématurées du projet, des opportunités de rediscuter les besoins et de lever progressivement les risques identifiés permet d’éviter tout un tas d’écueils, sans mentionner la sérénité associée.</p>]]></content><author><name></name></author><category term="Data" /><category term="IA" /><summary type="html"><![CDATA[Les projets data et IA peuvent durer de quelques semaines à quelques mois. Comment s'organiser pour mener à bien de tels projets et avec quels jalons ?]]></summary></entry><entry><title type="html">Ne laissez pas vos données devenir des Gremlins !</title><link href="http://ledatablog.com/data/bi/2019/11/14/ne-transformez-pas-vos-donnees-en-gremlins.html" rel="alternate" type="text/html" title="Ne laissez pas vos données devenir des Gremlins !" /><published>2019-11-14T00:00:00+00:00</published><updated>2019-11-14T00:00:00+00:00</updated><id>http://ledatablog.com/data/bi/2019/11/14/ne-transformez-pas-vos-donnees-en-gremlins</id><content type="html" xml:base="http://ledatablog.com/data/bi/2019/11/14/ne-transformez-pas-vos-donnees-en-gremlins.html"><![CDATA[<p>Tout comme les données que vous confient vos clients, particuliers ou professionnels, les <a href="https://gremlins.fandom.com/wiki/Mogwai">Mogwai</a>, sont de merveilleuses créatures, mais il faut leur accorder un soin particulier.
En effet, ne pas suivre quelques règles élémentaires peut rapidement les transformer en un véritable cauchemard.</p>

<p>Pourquoi avoir une source de données unique (single source of truth en anglais) pour vos données business est-il primordial, et à quels risques vous exposez-vous si vous ne disposez pas d’une telle source ? C’est à ces deux questions qu’on va tenter de répondre.</p>

<h1 id="ne-multipliez-pas-les-données">Ne multipliez pas les données</h1>

<p>Dans les films Gremlins, arroser un Mogwai le fait se multiplier.
Dupliquer les données est également une mauvaise idée pour plusieurs raisons.</p>

<h2 id="où-sont-passées-mes-données-">Où sont passées mes données ?</h2>

<p>Prenons l’exemple du nombre de fois où votre  plus gros client a réalisé une commande en 2018.
Il s’agit du problème le moins préoccupant : en fouillant un peu, vous retrouverez très probablement la donnée que vous cherchiez.
Peut-être dans la base de données comptabilisant les commandes, peut-être dans la base clients même si, comme il l’a été répété plusieurs fois en réunion, elle n’a rien à y faire.
Peut-être dans un rapport qui vous avait été confié, peut-être dans un mail reçu l’année dernière qui dressait la liste de vos meilleurs clients avec quelques informations supplémentaires.</p>

<p>Si vous ne parvenez toujours pas à la trouver, pas de panique, peut être que votre data scientist en avait une copie sur son poste pour ses analyses, que le marketing a des slides le présentant ou qu’un fichier Excel existe sur le poste du directeur commercial.</p>

<p>Donnée trouvée ? Parfait, car le vrai problème arrive.</p>

<h2 id="laquelle-est-la-bonne-">Laquelle est la bonne ?</h2>

<p>Avec un peu de malchance, vous vous êtes arrêté à la première donnée trouvée et vous vous êtes planté.
Le nombre de commandes est-il celui qui correspond aux factures émises en 2018 ? Ou bien aux livraisons effectuées en 2018 ?
Les commandes annulées sont-elles bien retranchées ? Et celles qui sont en défaut de paiement ? Tous les canaux de vente sont-ils bien pris en compte ?
Une commande ayant donné lieu à des livraisons récurrentes est-elle comptée une fois ou plusieurs fois ?</p>

<p>Si vous avez trouvé votre donnée dans un fichier Excel, sur des slides, ou plus généralement sur un poste de travail, il y a de grandes chances qu’il soit difficile de répondre à ces différentes questions. Vous pourriez même trouver des données qui se contredisent en fonction de leur provenance.
En ayant multiplié la donnée, vous avez perdu sa définition, sa tracabilité. Il n’y a plus qu’à trouver la personne qui a manipulé cette donnée en dernier, et espérer qu’elle se souvienne des traitements réalisés (si cette personne fait toujours partie de votre Entreprise !).</p>

<h2 id="une-source-de-données-unique">Une source de données unique</h2>

<p>Un principe important en data science BI est la source de données unique. Une base de données documentée, qui fait consensus dans la mesure du possible, et autorité dans tous les cas. Sans une source unique, la donnée a toutes les chances d’être ou de devenir mauvaise. Et une mauvaise donnée, c’est une donnée qui fait prendre de mauvaises décisions.</p>

<p>La construction d’un socle de données de référence est complexe, et est souvent un prérequis à la constitution, ou en tout cas au travail efficace, d’équipes dont le métier tourne autour de la donnée.</p>

<h1 id="la-transformation-en-mauvaise-donnée">La transformation en mauvaise donnée</h1>

<p>Dans Gremlins, si un Mogwai est nourri après minuit, il se transforme en une créature maléfique.
En ce qui concerne vos données, la transformation peut être lente comme très rapide.</p>

<h2 id="la-fuite">La fuite</h2>

<p>Le cas de figure extrême est la fuite de données. Hier elle était là, et aujourd’hui elle ne l’est plus. Pire encore, elle est partout, et surtout au délà de vos murs. D’un coup, vos concurrents ont accès à toutes les informations dont ils ont toujours rêvé.</p>

<p>Ceci peut arriver de tas de façons différentes, mais la plus fréquente n’est pas le piratage ou la malveillance, il s’agit plutôt de <a href="http://www.nbcnews.com/id/7032779/ns/technology_and_science-security/t/bank-america-loses-customer-data/#.WHPYpVMrJUQ">la maladresse humaine</a>.
Et plus vos données sont éparpillées entre vos murs, sur les postes de différents collaborateurs, dans les boîtes mails, plus vous êtes à risque de voir tout ou partie s’envoler.</p>

<p>Une seule façon de s’en prémunir, avoir un responsable de la sécurité fiable, compétent, à qui une très grande latitude est laissée et auquel des moyens sont fournis. Et vu que ce n’est pas mon métier et que ça ne s’improvise pas, je me garderai bien d’en dire davantage.</p>

<h2 id="lobsolescence">L’obsolescence</h2>

<p>La donnée périme. A minima sa définition périme. Les données doivent donc être entretenues, mises à jour, et supprimées lorsque nécessaire. Vos produits changent de prix, ils évoluent. Vos clients changent, leurs propiétés également.
Les données qui y sont liées doivent évoluer de façon synchrone, sans perdre d’historique.</p>

<p>Ces évolutions pourtant nécessaires sont souvent douloureuses lorsqu’elles ne sont pas anticipées, avec des bases de données mal agencées, mal documentées, peu exploitables.
Sans ces mises à jours, vos données finiront par mentir, ouvrant la voie à de mauvaises prises de décisions qu’il sera très complexe d’analyser.</p>

<h1 id="la-destruction">La destruction</h1>

<p>Pour les Gremlins, c’est simple, il suffit de les exposer à une lumière vive.
Pour les données, sans source unique, c’est bien plus complexe.</p>

<h2 id="une-fausse-impression-de-sécurité">Une fausse impression de sécurité</h2>

<p>Vous avez reçu un mail demandant à appliquer la RGPD et à supprimer toutes les données que vous avez sur un client ? Rien de plus facile, vous avez une procédure de prête pour ça, et en remplissant un simple formulaire, la donnée disparaît. Mais a-t-elle vraiment totalement disparu ?</p>

<p>Si vous n’avez pas de source de données unique, il y a fort à parier que des informations sur le client se trouvent sur les postes de travail de vos collaborateurs, sur des bases de données annexes, qui ne sont presque jamais utilisées. Presque. Et un jour, elles risquent d’être réinjectées par mégarde <a href="https://www.theregister.co.uk/2017/10/30/heathrow_usb_security_blunder/">ou même fuiter</a>.</p>

<p>La seule solution est alors de s’assurer que, dans chaque service, chaque collaborateur ait bien effacé la donnée s’il l’a déjà eu entre les mains. Un peu plus complexe qu’un simple formulaire à remplir, et surtout beaucoup moins fiable…</p>

<h1 id="conclusion">Conclusion</h1>

<p>Un socle de données unique est long et coûteux à mettre en place, et ses avantages ne sont visibles qu’à moyen et long terme.
Il est cependant indispensable de disposer de telles sources de données afin de mener des analyses business data poussées dans de bonnes conditions.</p>

<p>Beaucoup de sujets n’ont pas été abordés ici, comme les contrôles d’accès à ces socles, les différentes technologies permettant de mettre les mettre en place ainsi que les avantages en terme de productivité pour ses utilisateurs, et en termes de prise de décision pour les dirigeants. Peut-être l’objet pour un futur billet !</p>]]></content><author><name></name></author><category term="Data" /><category term="BI" /><summary type="html"><![CDATA[Ne pas prendre assez soin de ses données clients expose à de nombreux risques. Pourquoi avoir une source de données unique (single source of truth) est-il primordial, et à quels risques vous exposez-vous si vous n'en disposez pas ?]]></summary></entry><entry><title type="html">Hello World !</title><link href="http://ledatablog.com/meta/2019/10/21/hello-world.html" rel="alternate" type="text/html" title="Hello World !" /><published>2019-10-21T00:00:00+00:00</published><updated>2019-10-21T00:00:00+00:00</updated><id>http://ledatablog.com/meta/2019/10/21/hello-world</id><content type="html" xml:base="http://ledatablog.com/meta/2019/10/21/hello-world.html"><![CDATA[<p>Bienvenue sur ledatablog !</p>

<p>L’objectif de ce blog est de parler de la data au sens large. Les sujets abordés seront essentiellements les suivants :</p>
<ul>
  <li>l’Intelligence Artificielle</li>
  <li>la Business Intelligence</li>
  <li>le langage de programmation Python</li>
  <li>La data</li>
</ul>

<p>Voyons rapidement sous quels biais ces thématiques seront traitées :</p>

<h1 id="lintelligence-artificielle">L’Intelligence Artificielle</h1>

<p>Les articles de presse <a href="https://lexpansion.lexpress.fr/high-tech/va-t-on-vers-une-intelligence-artificielle-a-la-terminator_1932888.html">vendent parfois l’IA comme l’équivalent de Terminator</a>.
Elon Musk déclarait par exemple en 2017 “L’IA est le plus grand risque qui nous menace en tant que civilisation”.
Au risque de décevoir les amateurs de science fiction, l’Intelligence Artificielle telle qu’elle existe aujourd’hui, et telle qu’elle est envisagée pour, a minima, <a href="https://www.theverge.com/2018/11/27/18114362/ai-artificial-general-intelligence-when-achieved-martin-ford-book">les dizaines d’années à venir</a>, n’a rien à voir avec une prise de pouvoir par les robots.
Cela n’empêche pas que l’automatisation du travail est aujourd’hui une réalité qui s’accélère, même si celle-ci est en grande partie dûe à une informatisation à laquelle l’Intelligence Artificielle est assez étrangère.
En bref, de nombreux emplois sont automatisés, mais c’est bien davantage grâce à des programmes informatiques “basiques” (gestion d’emploi du temps, réservation en ligne, …) que grâce à des algorithmes faisant appel à une quelconque IA (même si ces derniers existent et commencent à jouer un rôle).</p>

<p>On parlera donc dans ce blog de l’Intelligence Artificielle comme domaine de recherche, et probablement plus spécifiquement du traitement des langages, c’est à dire de ce que l’ordinateur est capable de faire avec du texte “humain”. Cela recouvre des sujets tels que la traduction automatique, la génération automatique de résumés, l’analyse de sentiments, détection de fake news, …
On parlera également à l’occasion de l’impact de ces approches sur la société, ou de lectures à ce sujet.</p>

<h1 id="la-business-intelligence">La Business Intelligence</h1>

<p>La Business Intelligence (Informatique décisionnelle en français, convenez que c’est moins sexy) est la discipline qui consiste à aider les décideurs ou dirigeants d’Entreprise dans leurs décisions.
La BI commence par une visualisation “simple” des données de l’Entreprise (chiffre d’affaires et sa ventilation, comptage des clients et de leurs dépenses, …) pour ensuite permettre l’analyse de ces données et la création d’indicateurs pertinents (<em>churn</em> ou nombre de clients résiliant chaque mois, prévisions de chiffre d’affaire, …) et, en bout de chaîne, mettre en place des actions pour améliorer la santé de lEntreprise (orientation des forces commerciales, communications personnalisées avec les clients, prévention du <em>churn</em>, priorisation des prospects, …).</p>

<p>On parlera ici de certains cas d’usages et de l’intérêt de l’exploitation de la data, y compris par des Entreprises de taille moyenne.
On y parlera néanmoins pas d’Intelligence Artificielle appliquée au business, étant donné que les exceptionnelles Entreprises concernées par ce genre d’approches sont les très (très) grandes Entreprises, et que l’immense majorité des approches de BI ne font pas appel à l’IA, mais à des approches statistiques “standards”.</p>

<h1 id="le-langage-de-programmation-python">Le langage de programmation Python</h1>

<p>Python est un langage de programmation informatique, leader dans le domaine de l’Intelligence Artificielle, et leader dans la BI dès lors que l’on sort des approches par interface (la majorité de la BI est réalisée via des outils type Qlik ou SAS, aux licences coûteuses, mais plus simples à utiliser grâce à leurs interfaces graphiques).</p>

<p>Ce blog a une vocation plutôt généraliste, et on évitera tant que possible les billets spécialisés sur le langage, mais étant un grand utilisateur, et participant occasionnellement à des conventions autour du langage, il est probable que quelques articles s’y attardent.</p>

<h1 id="la-data">La data</h1>

<p>Certains cas d’usages ne rentrent ni dans la BI, ni dans l’IA. J’ai par exemple, durant les élections 2017, écrit plusieurs billets sur l’usage de Twitter des candidats, et réalisé quelques analyses statistiques de leurs discours. Ces billets seront republiés ici, et j’encourage vivement à la reprise de ces travaux lors des prochaines échéances électorales. Elles apportent un éclairage intéressant, et ont été <a href="https://medium.com/@Stratifyd/who-are-you-with-data-visualization-of-trump-and-clintons-facebook-pages-149a1c2a9f47">assez présentes aux US lors des dernières élections</a>, mais assez peu en France.</p>]]></content><author><name></name></author><category term="Meta" /><summary type="html"><![CDATA[Petite description des 4 types de contenus qui apparaîtront dans ce blog : l'IA, la BI, Python, et la data.]]></summary></entry></feed>